피지컬 AI는 올해 크리스마스 선물이 될 겁니다
오간 이야기
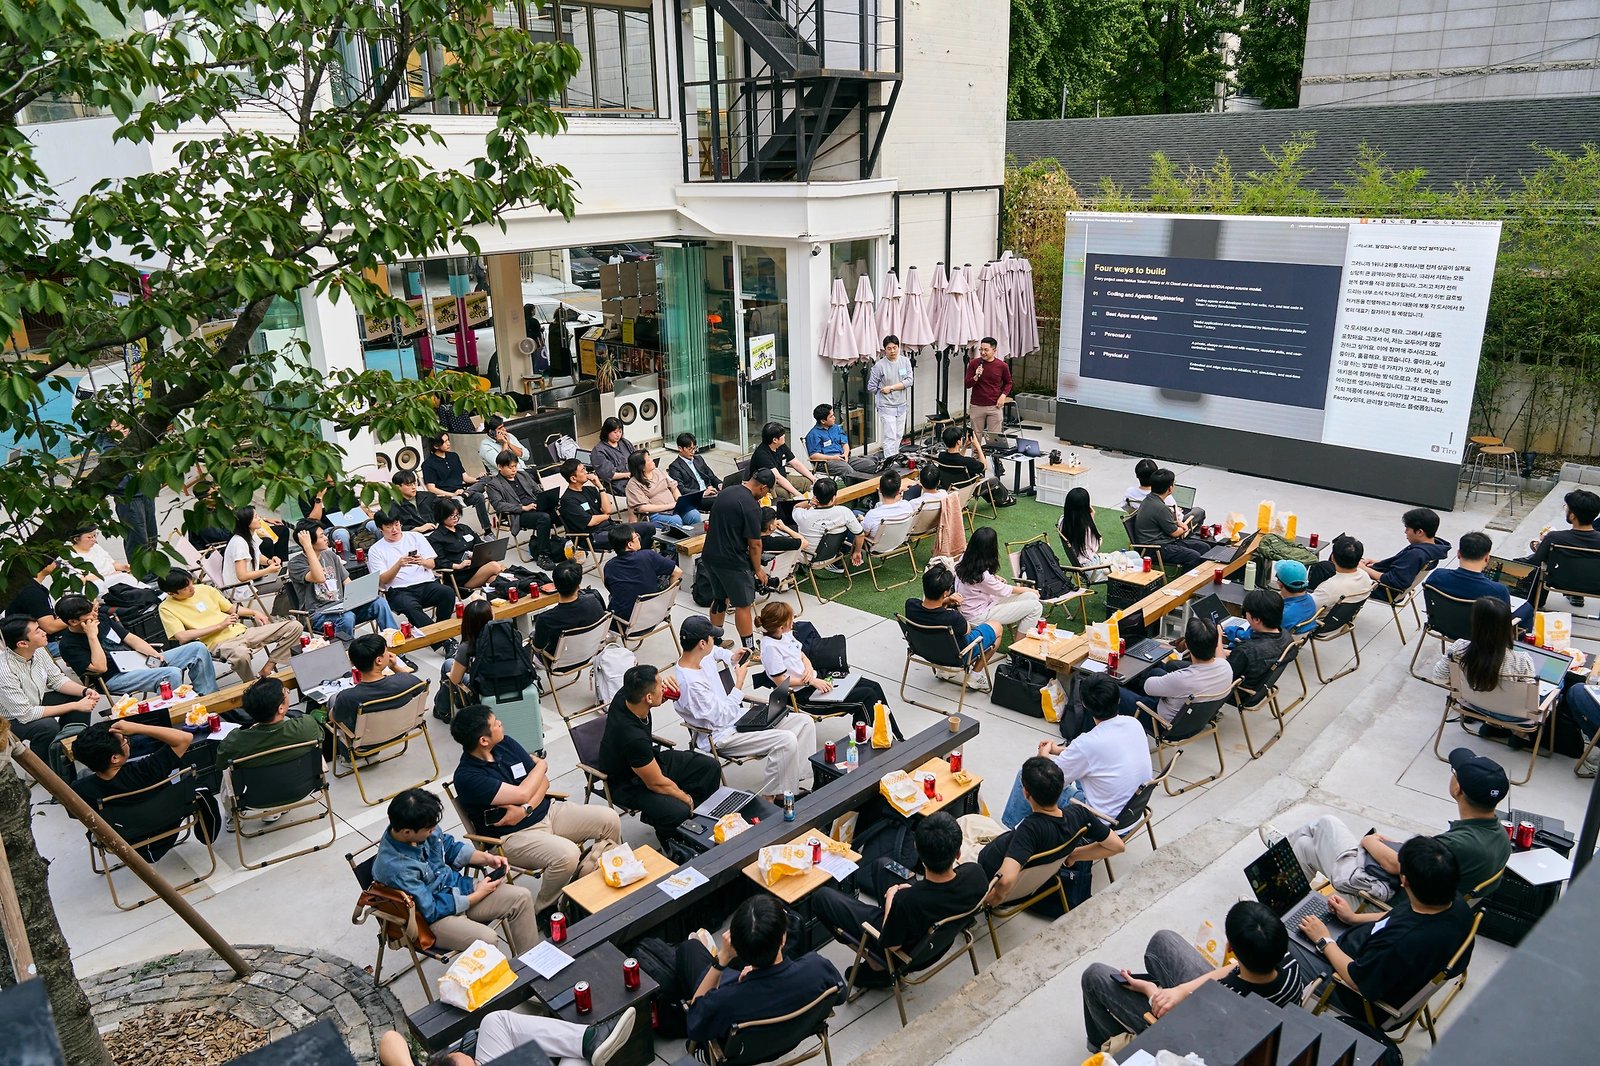
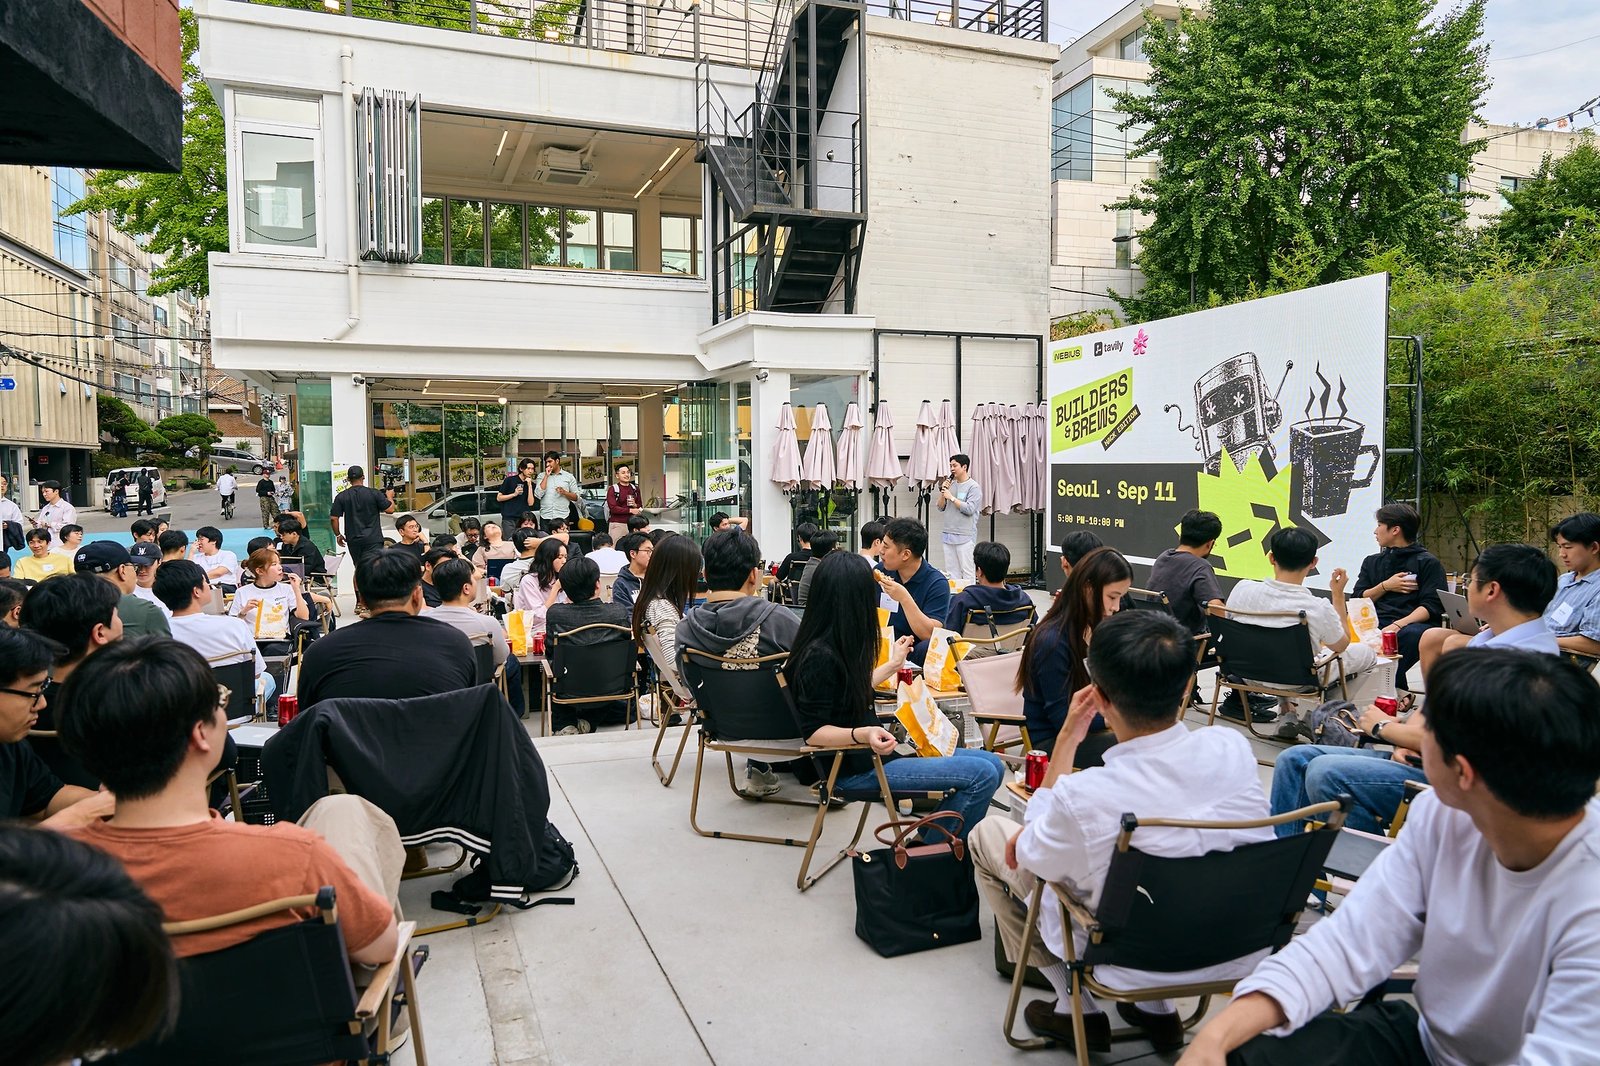
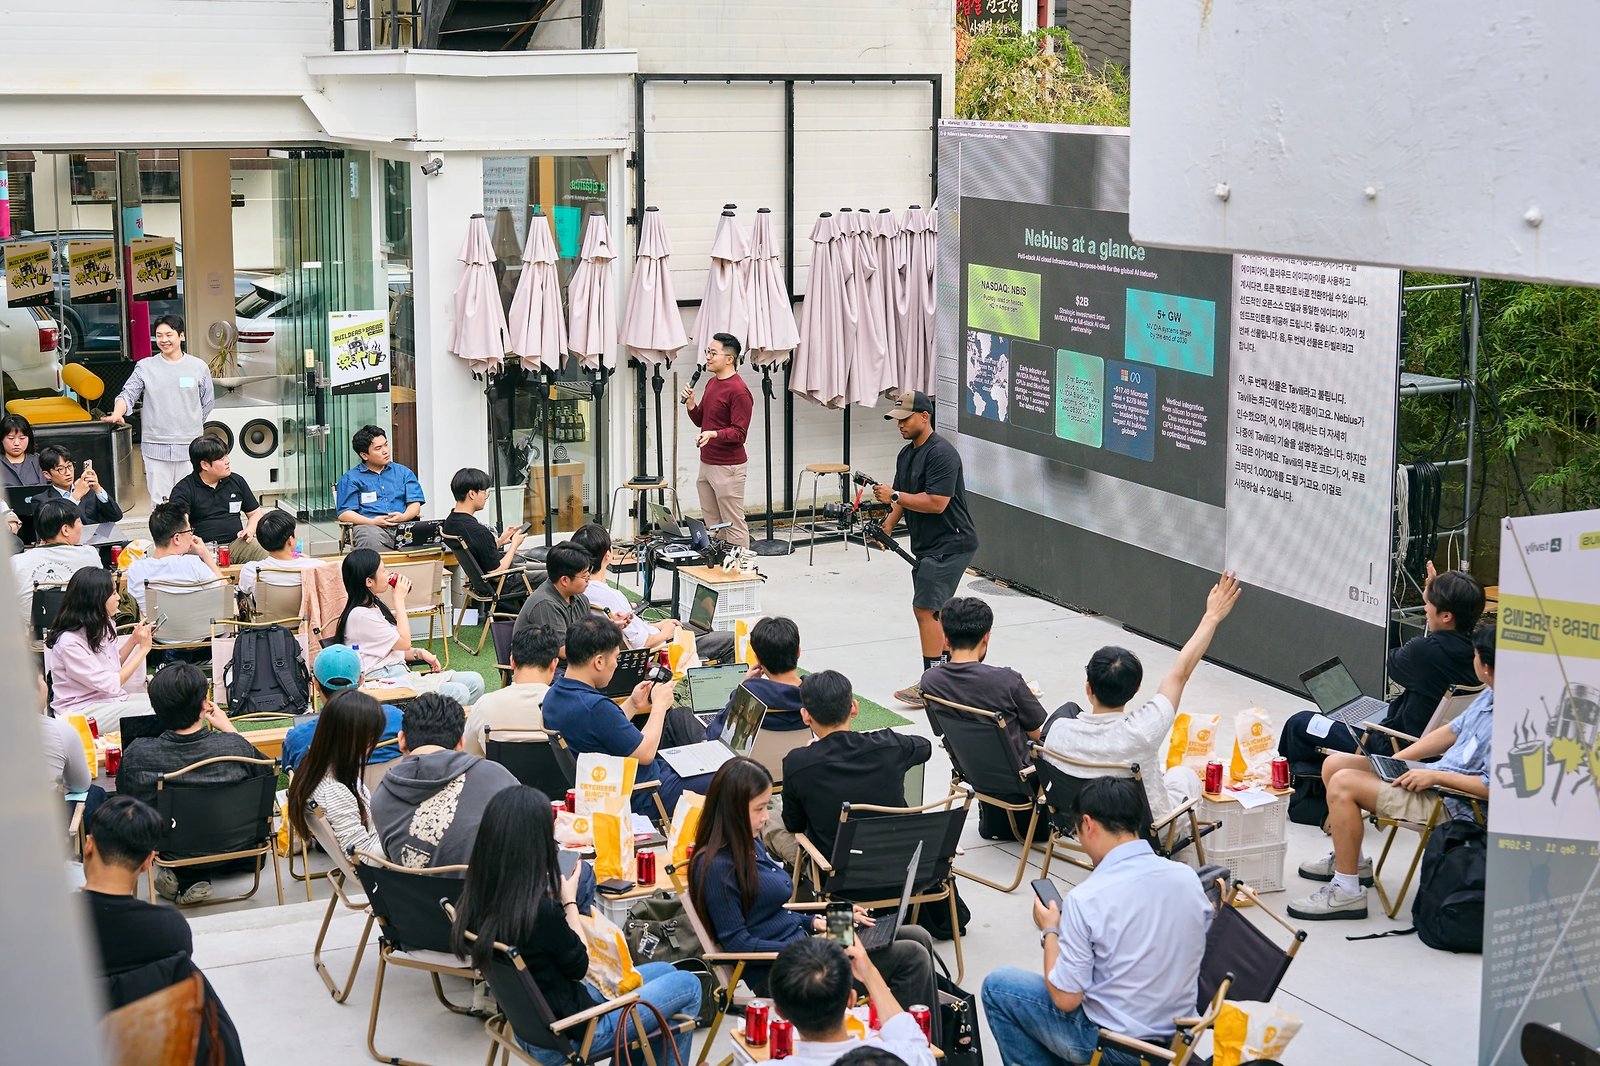
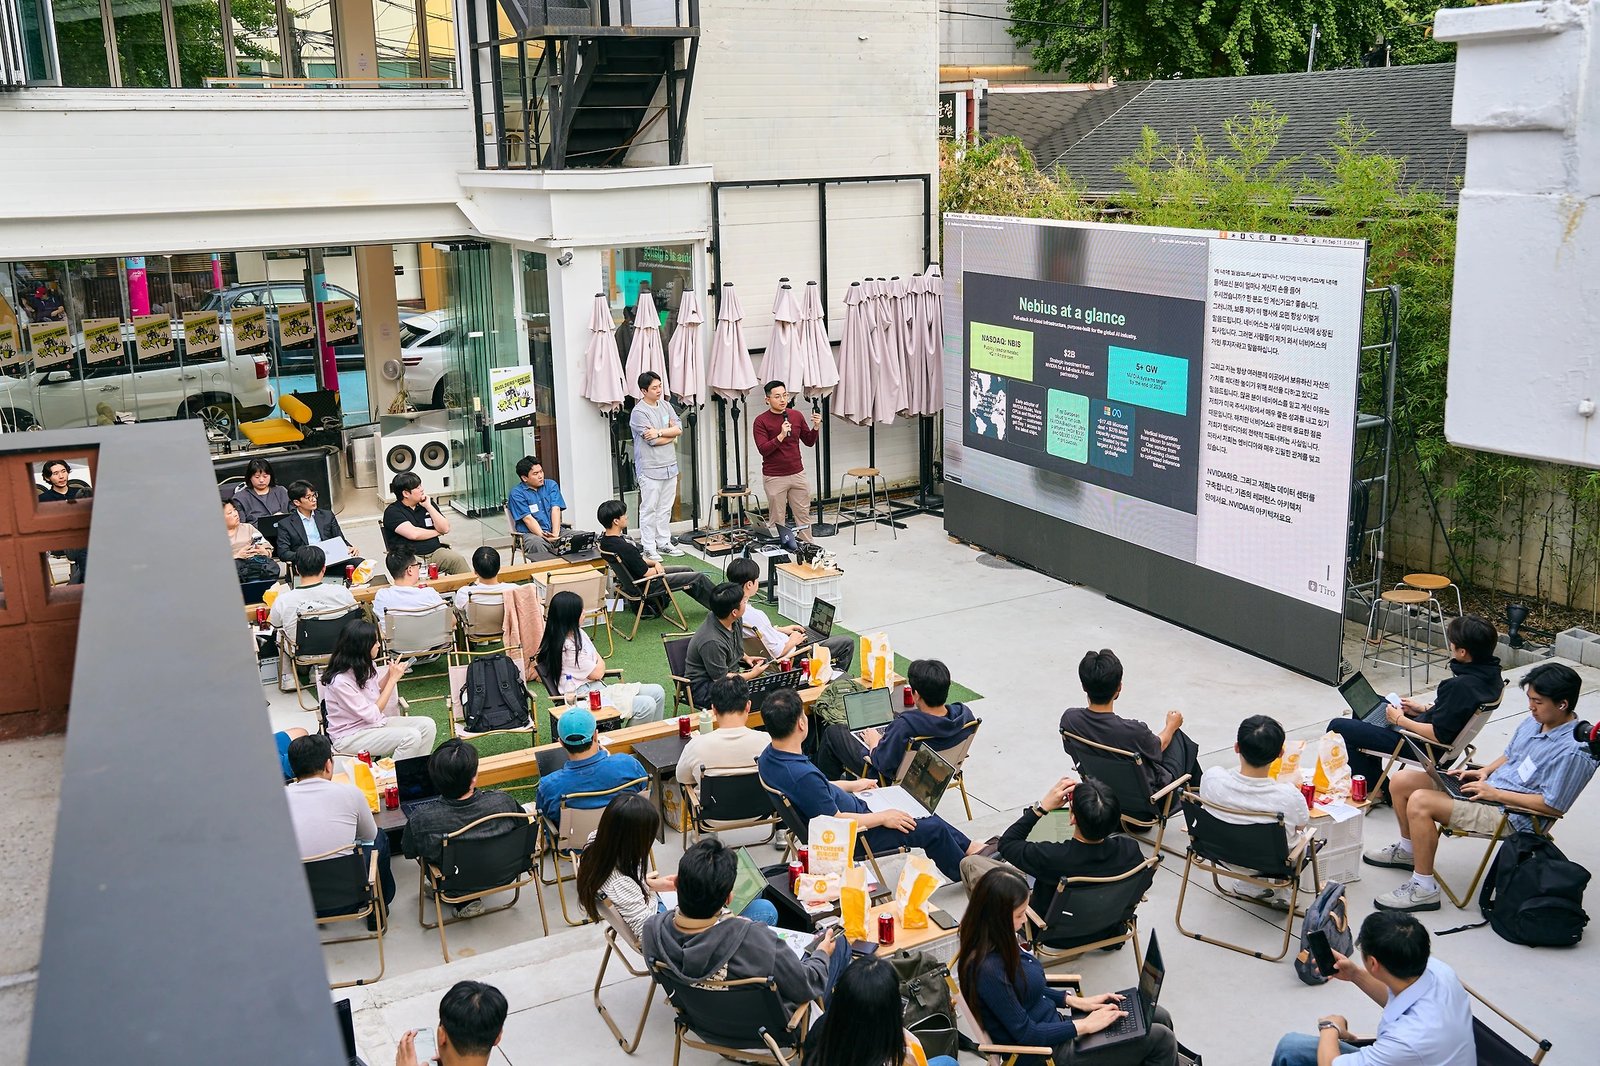
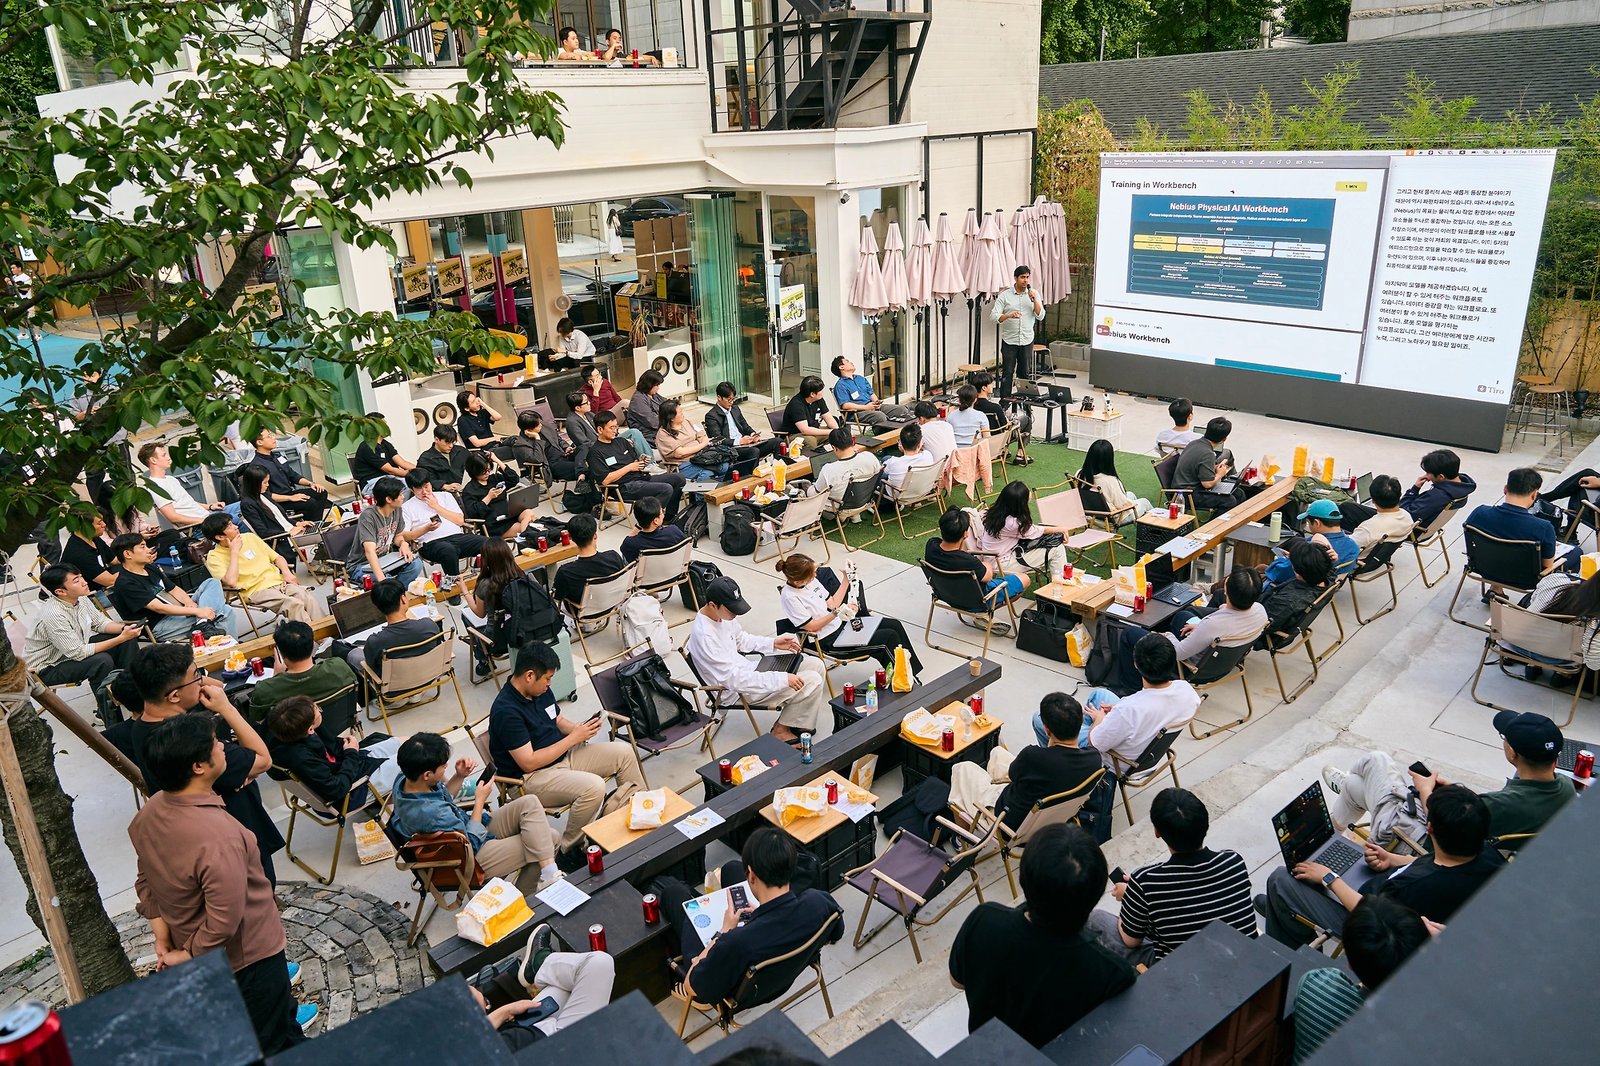
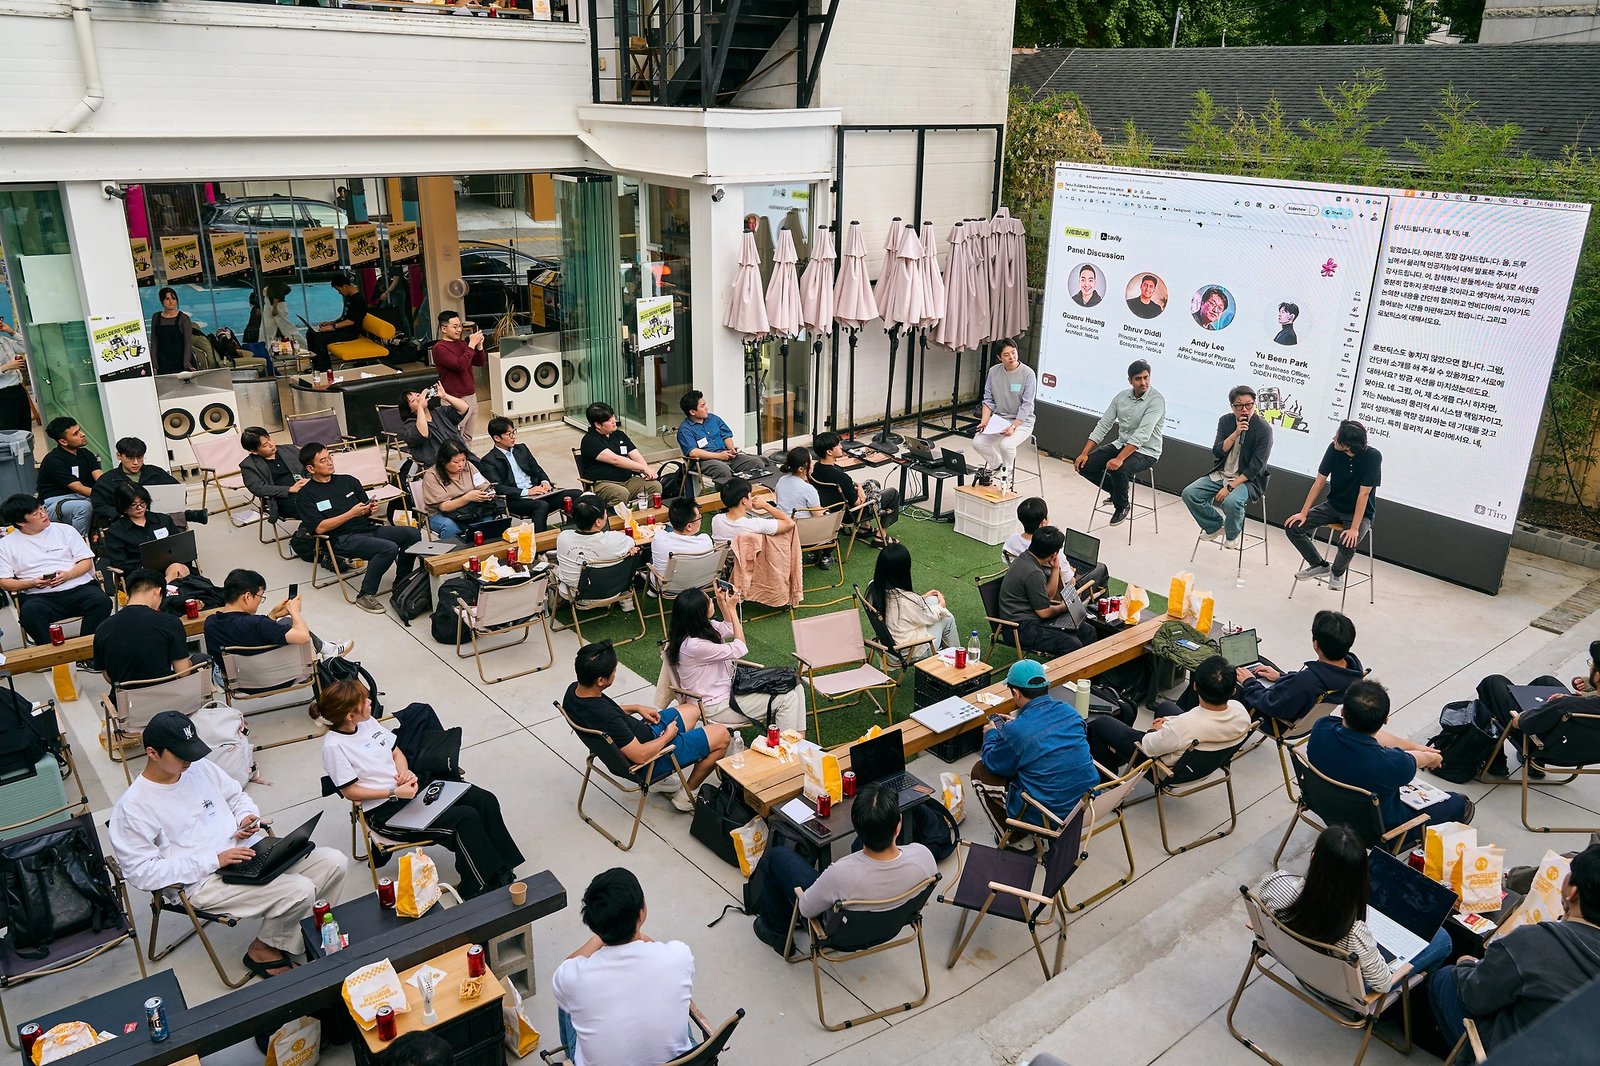
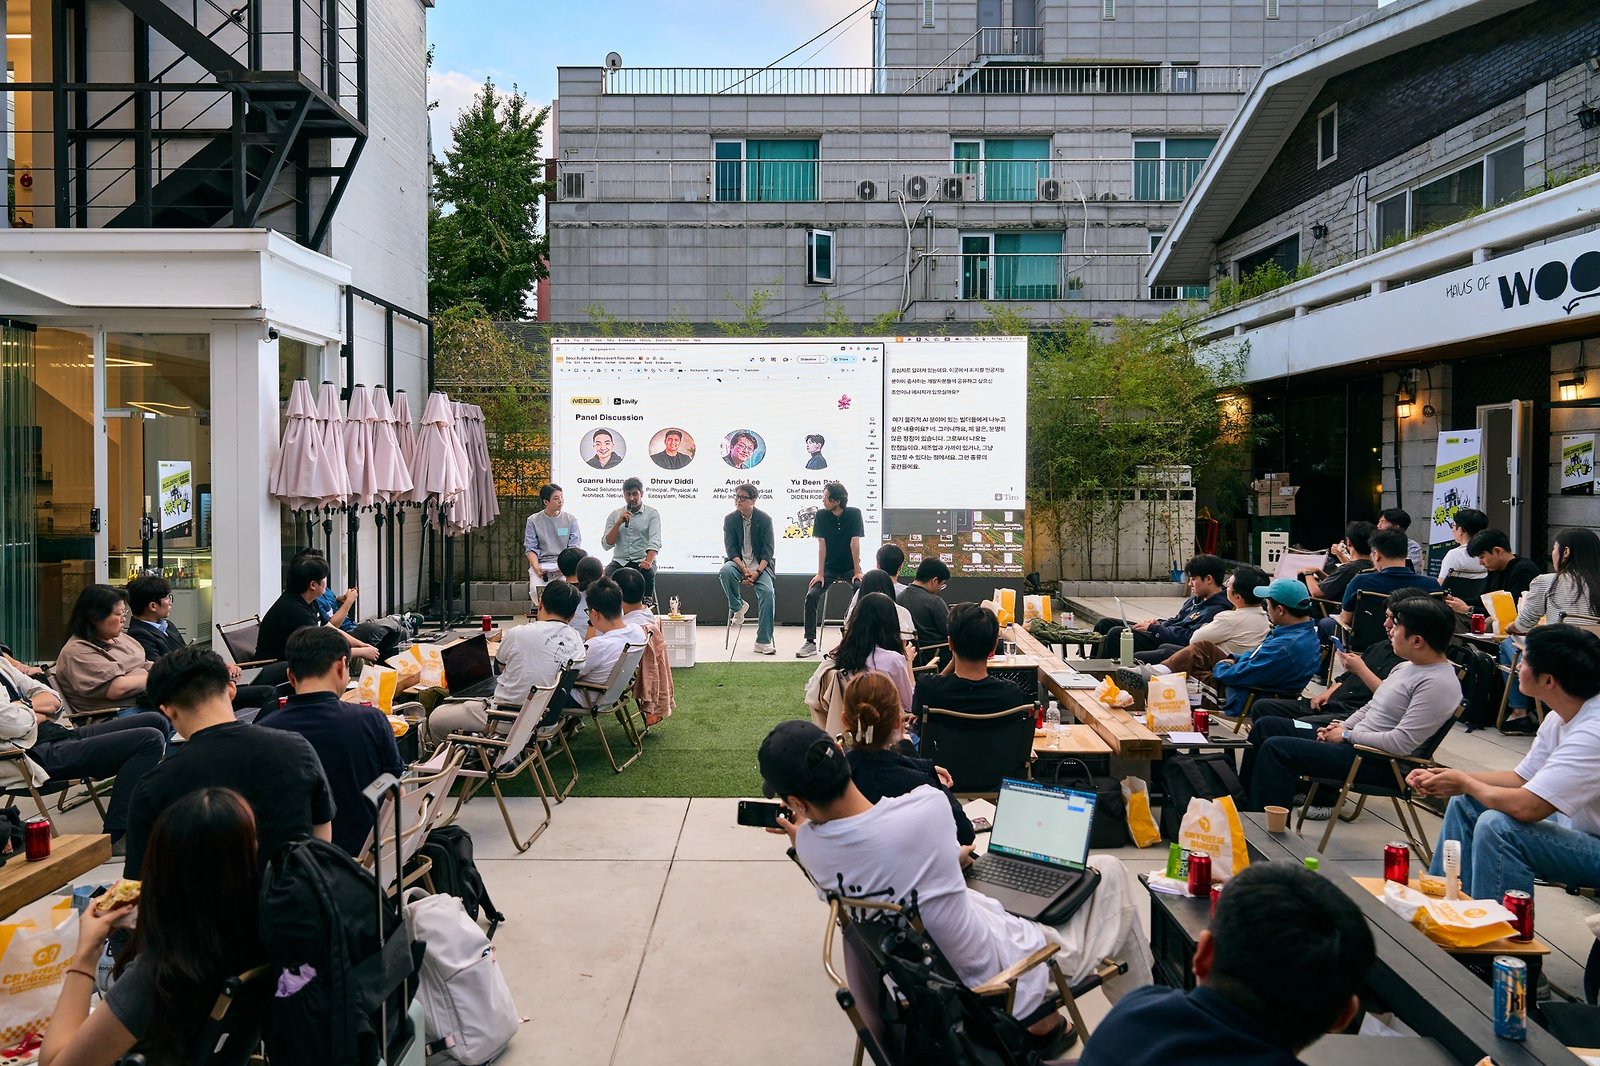
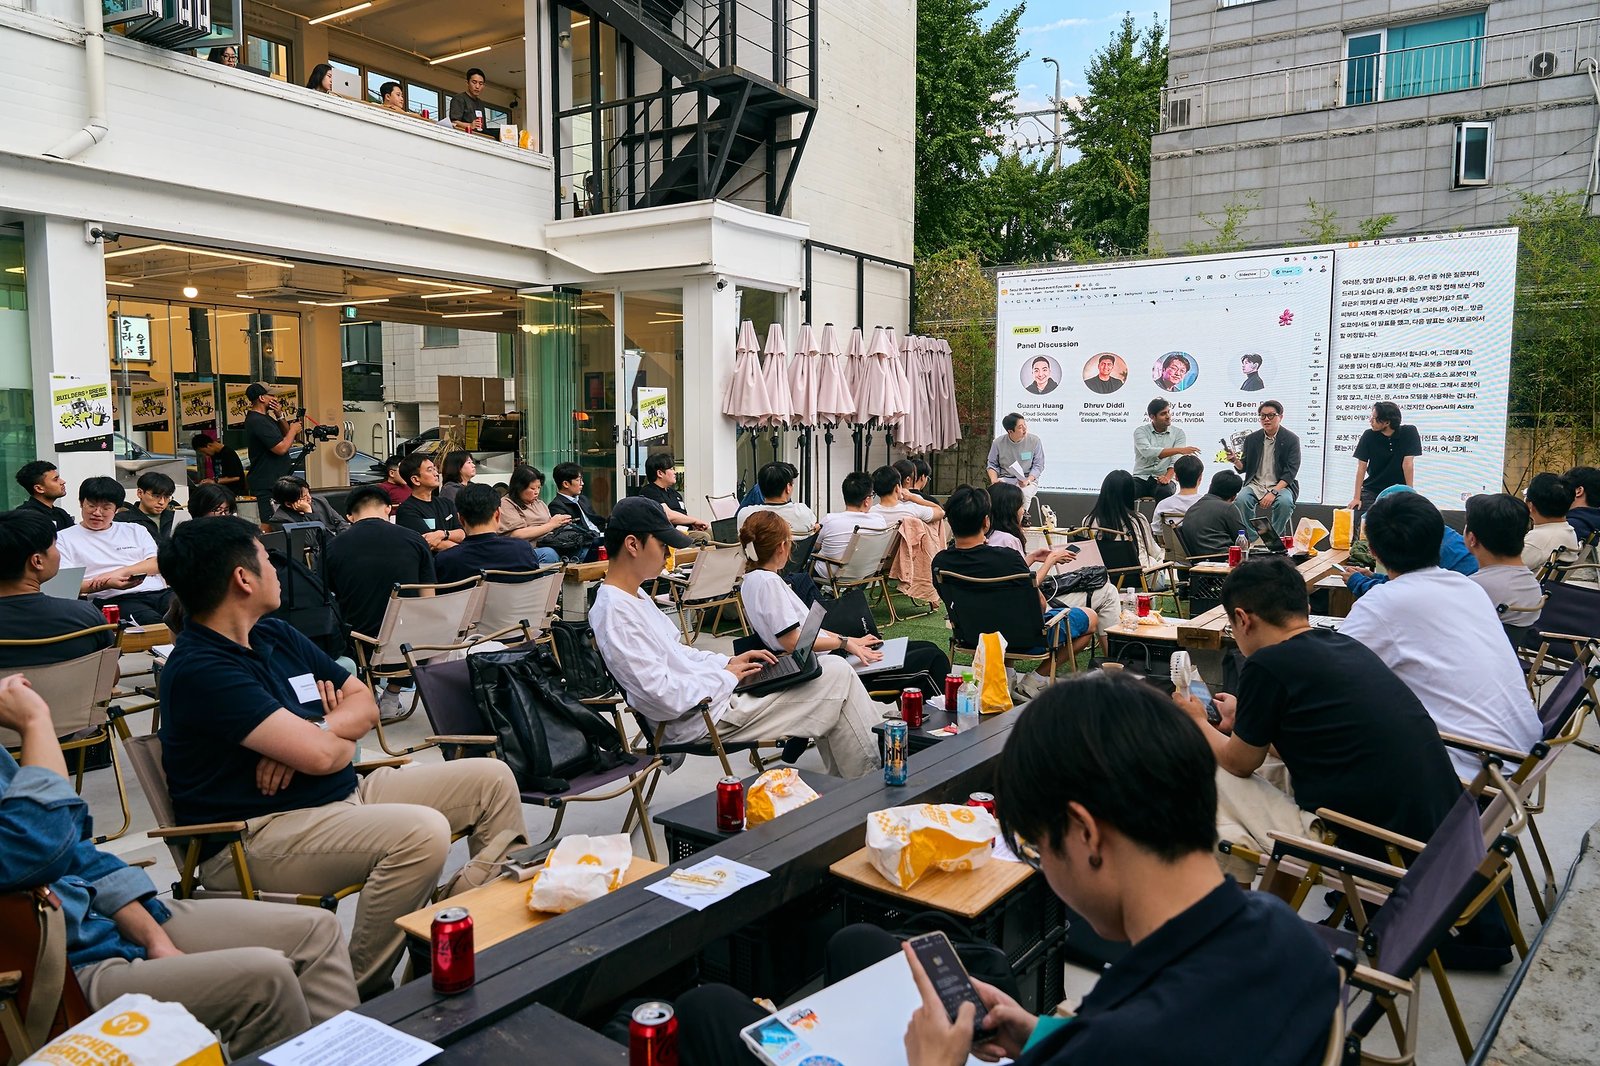
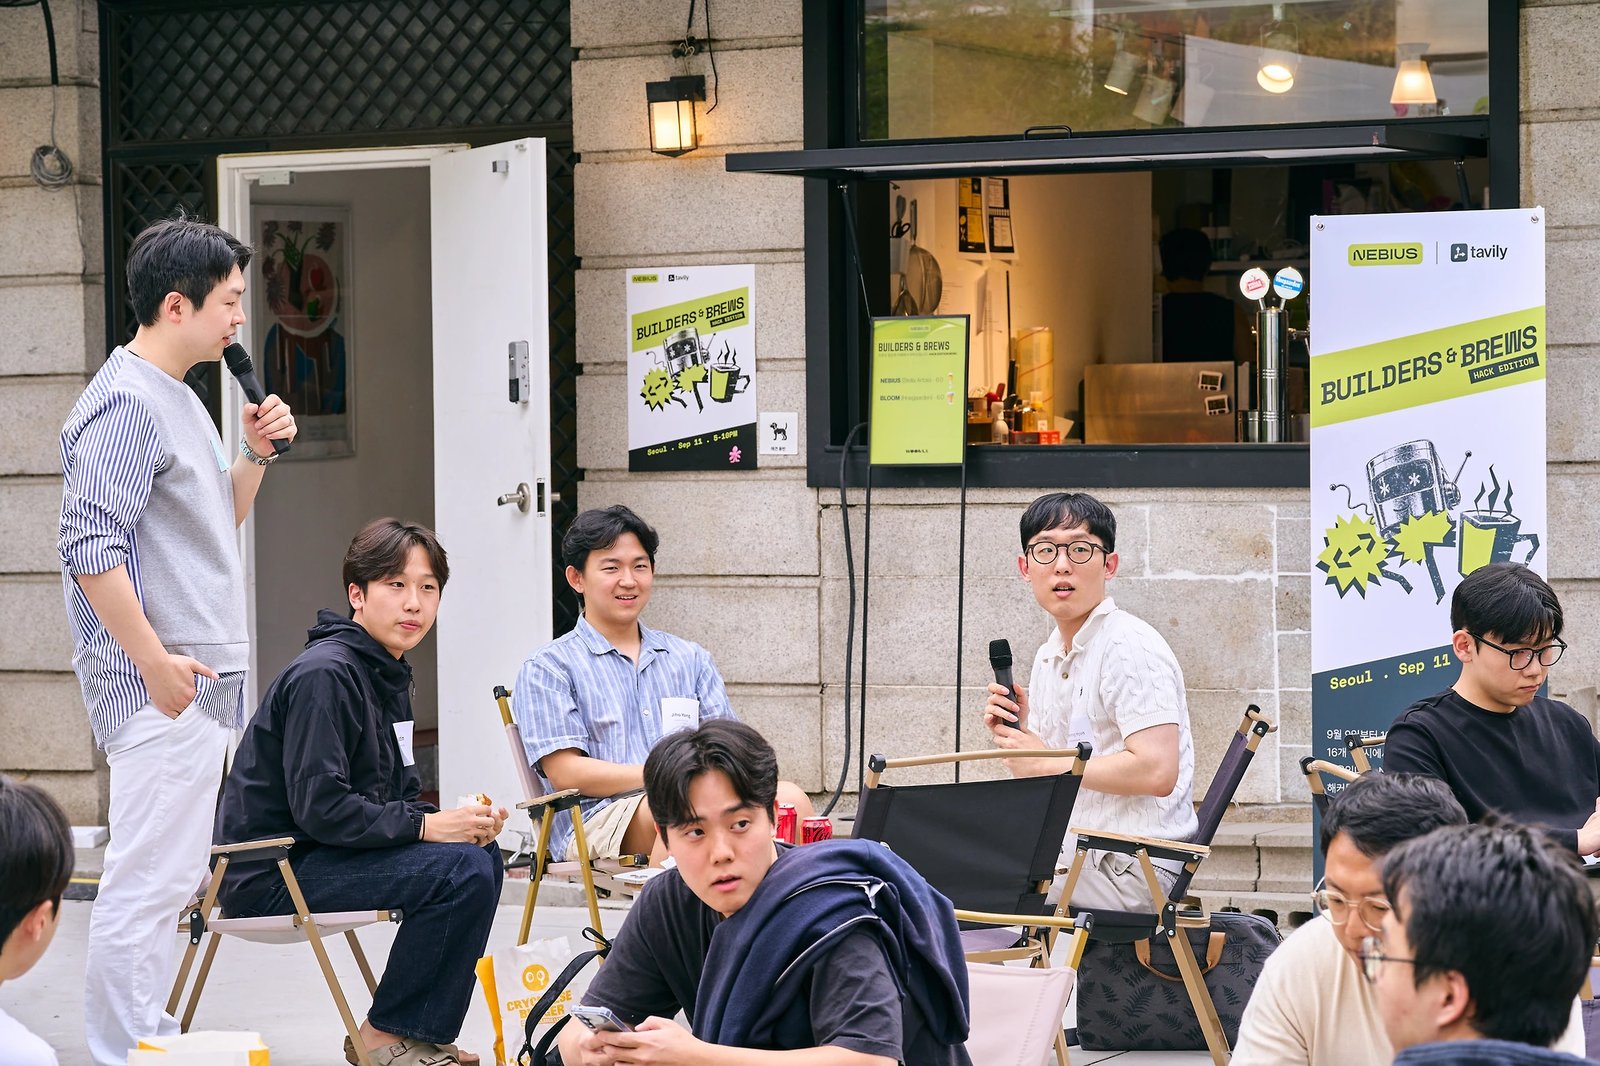
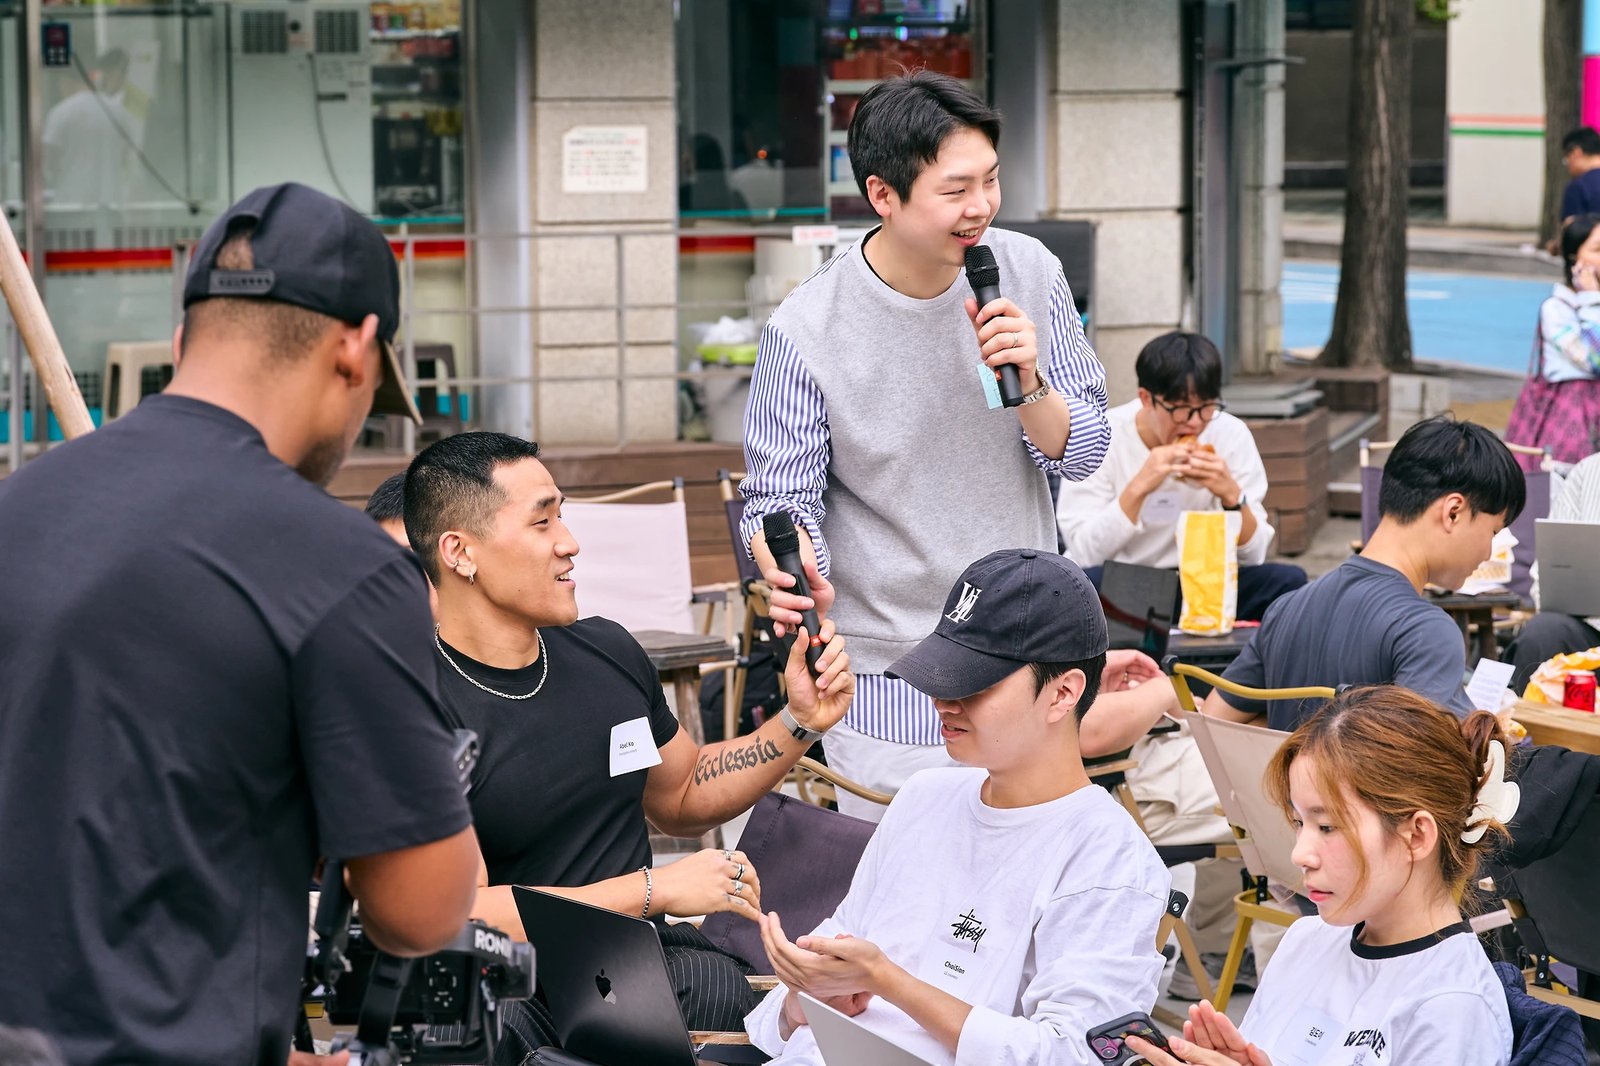
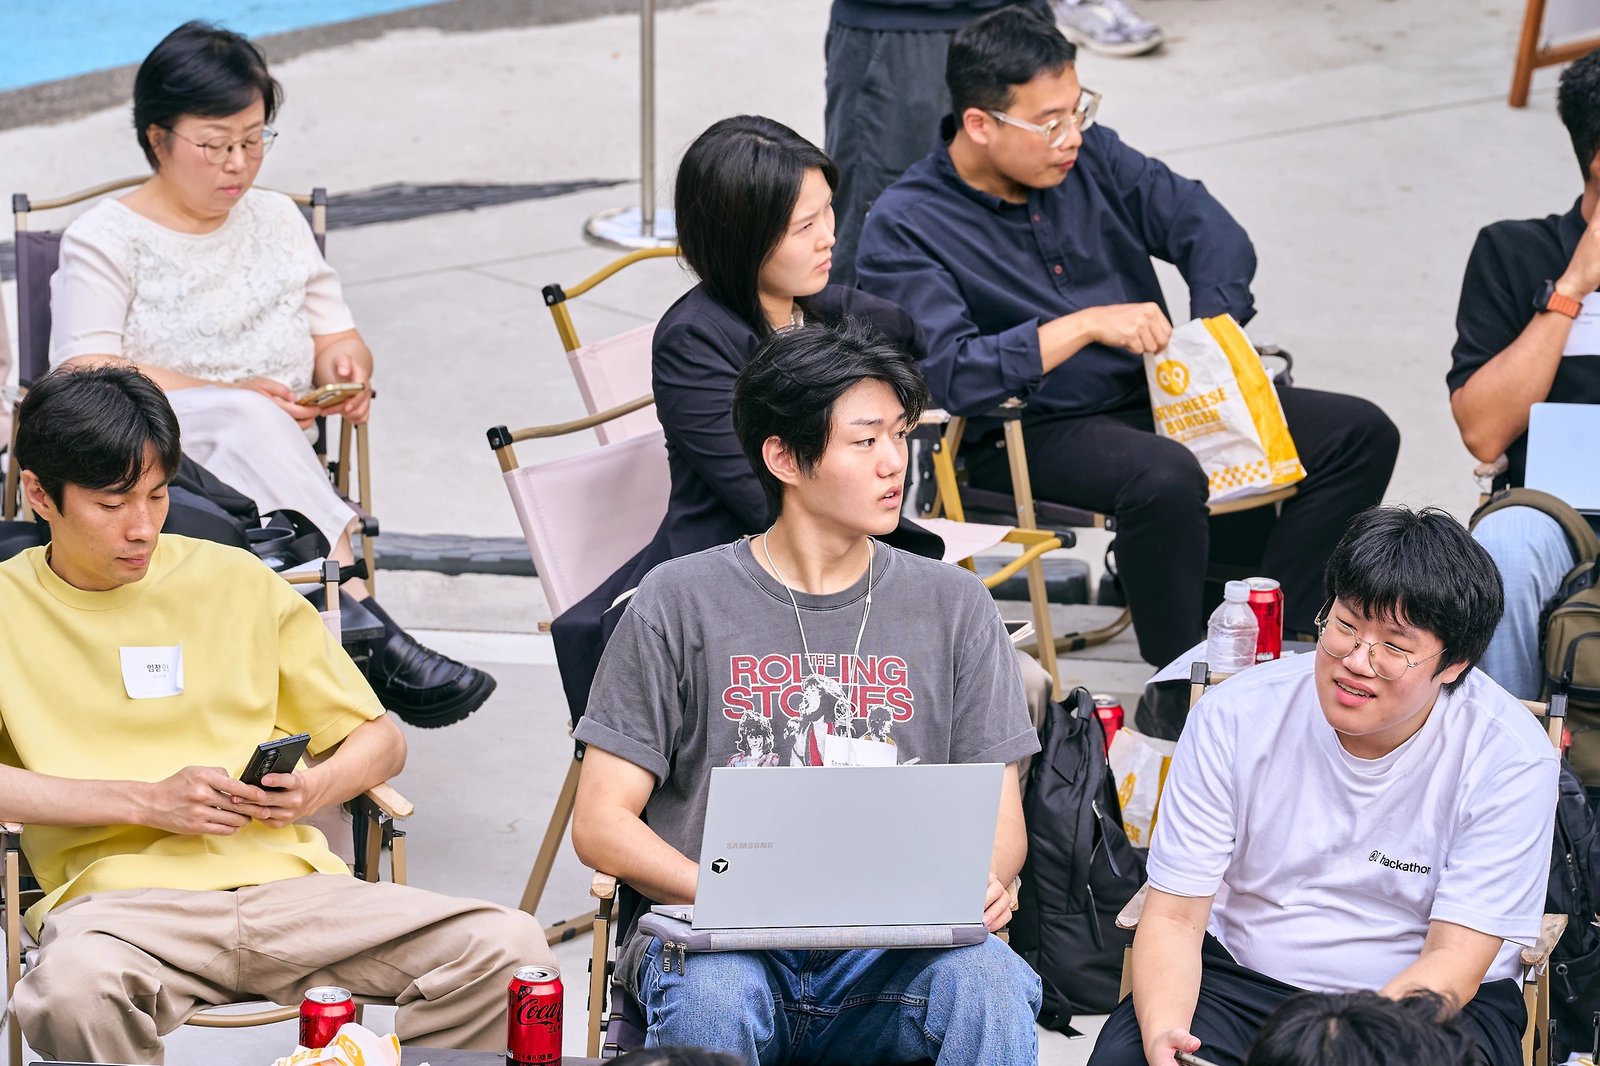
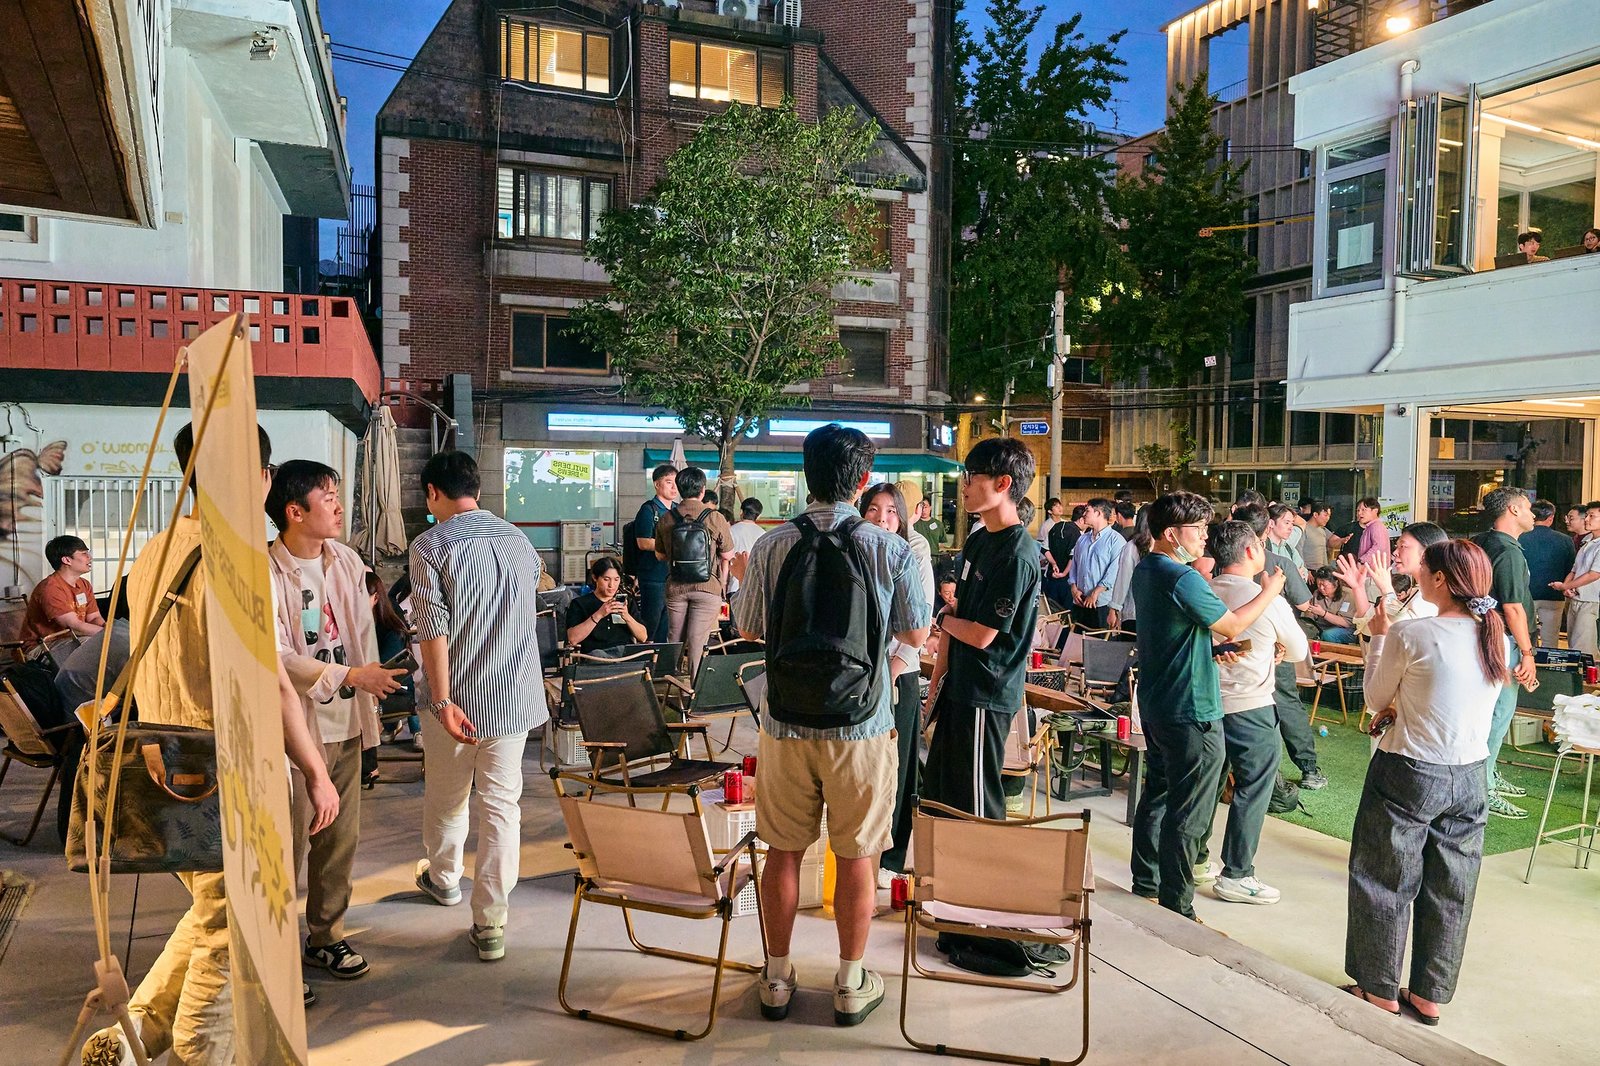
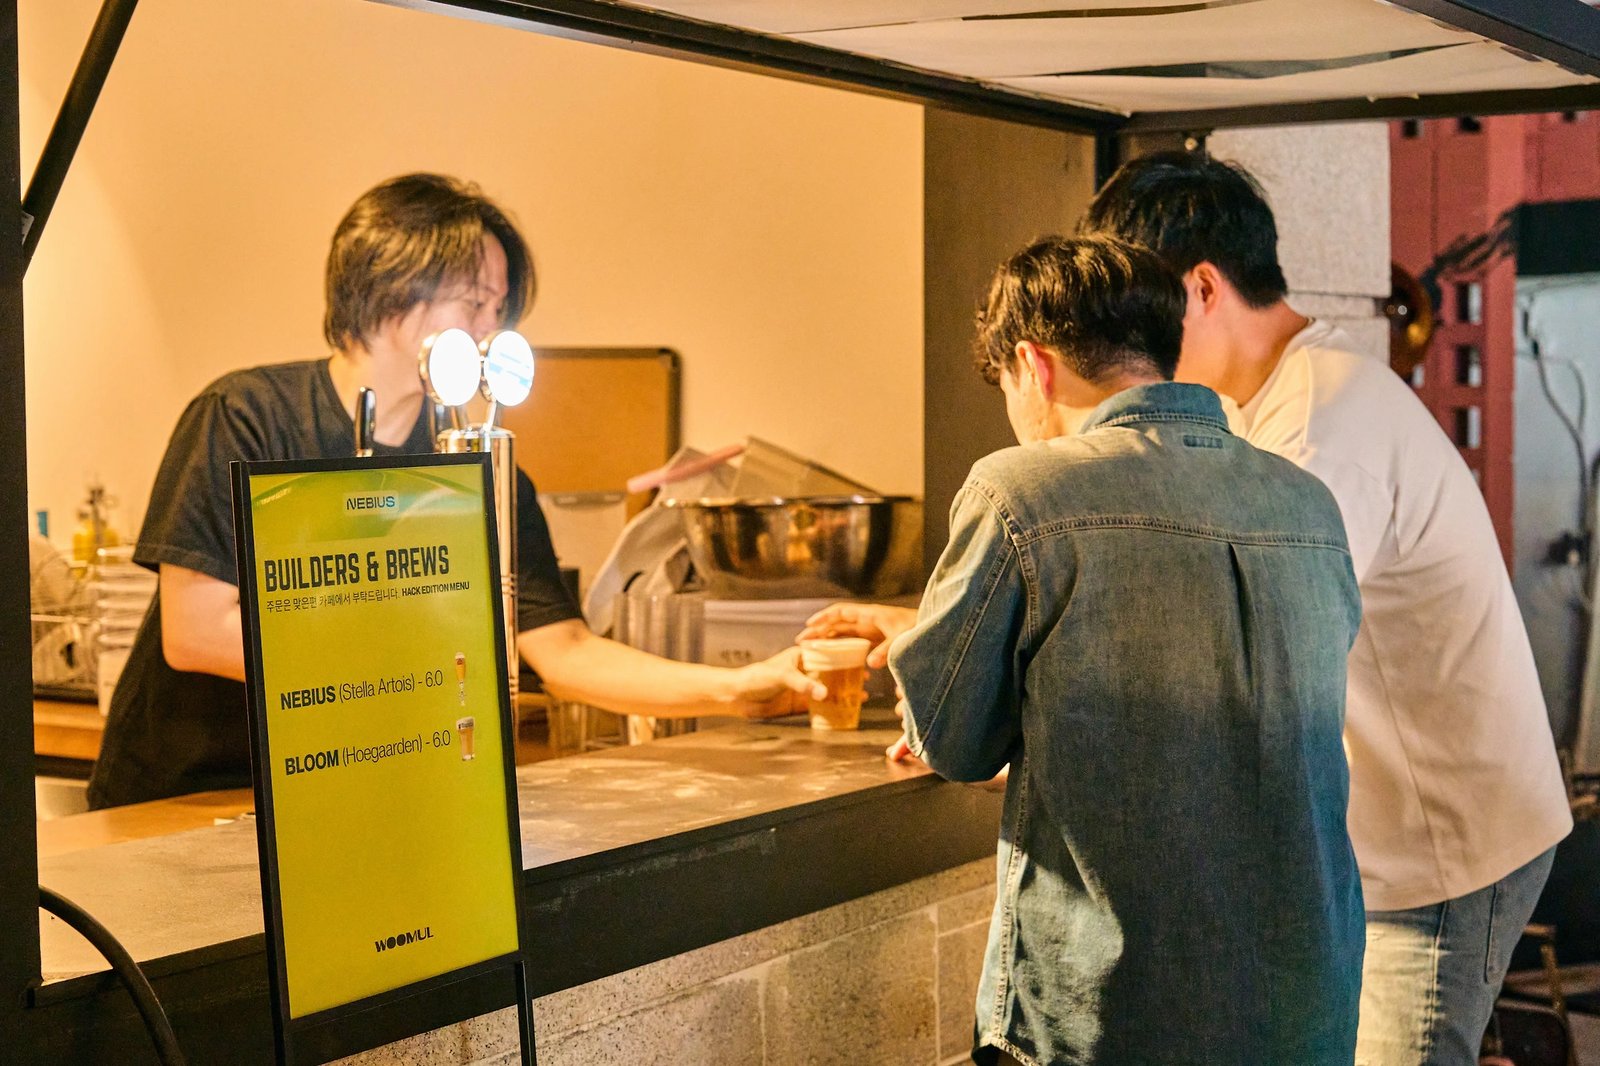
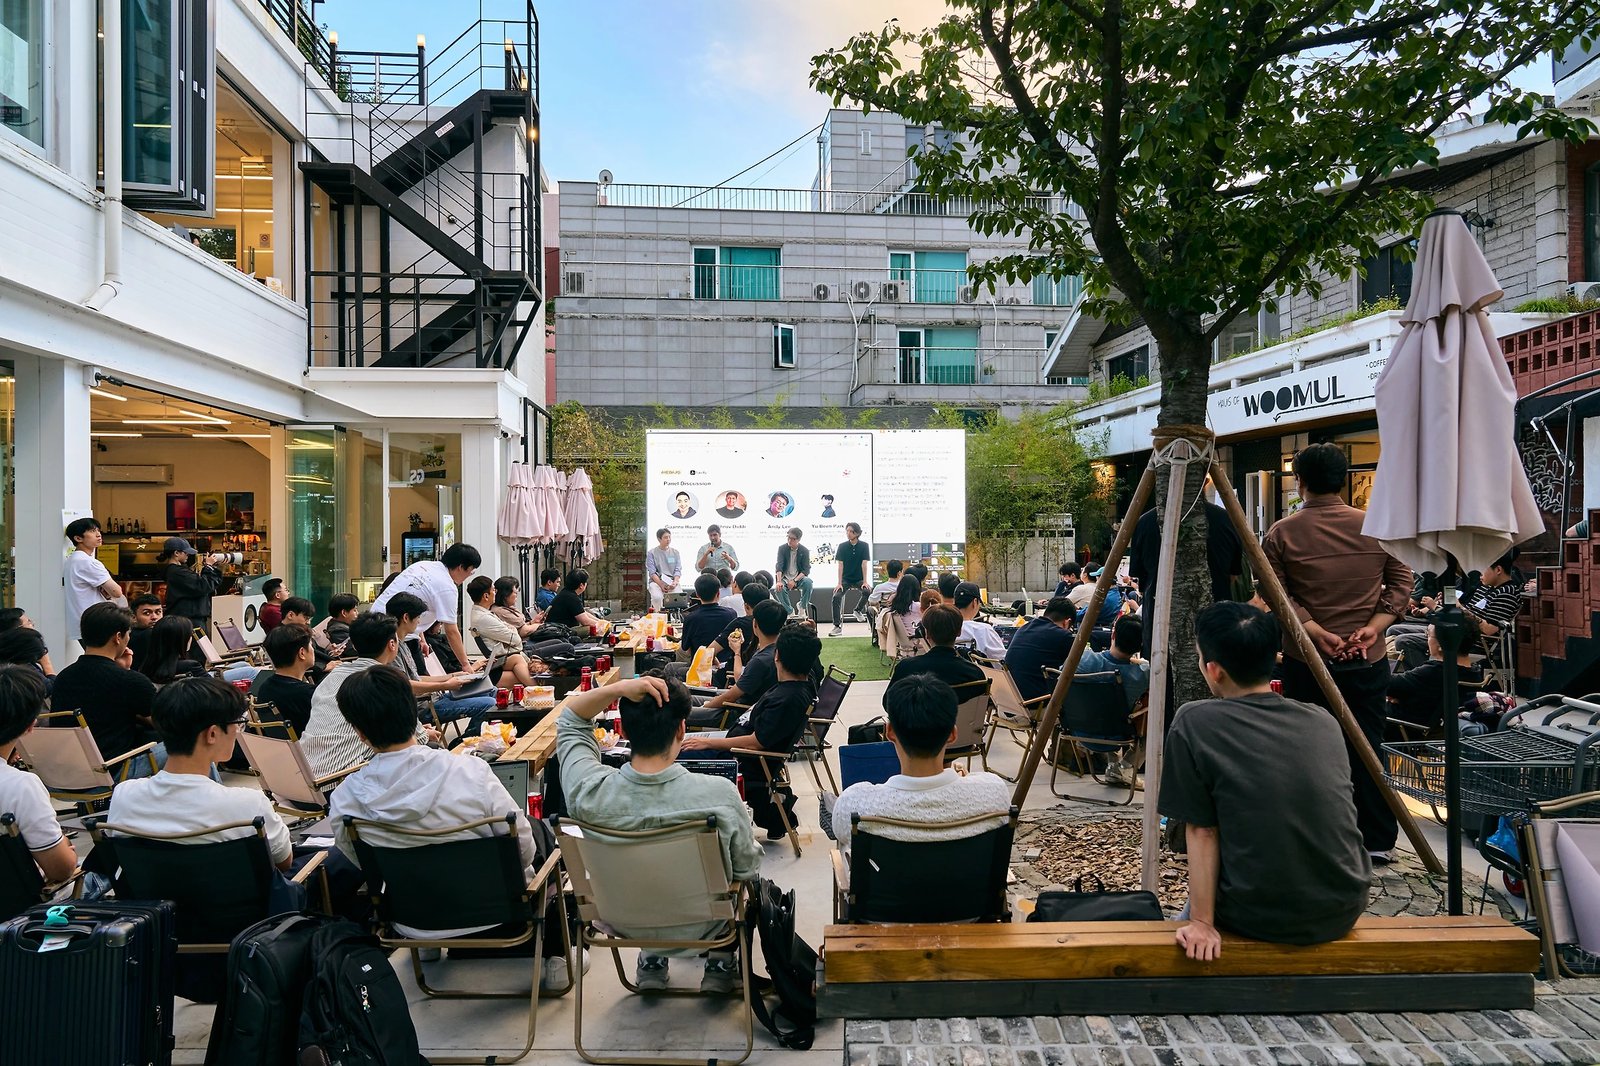
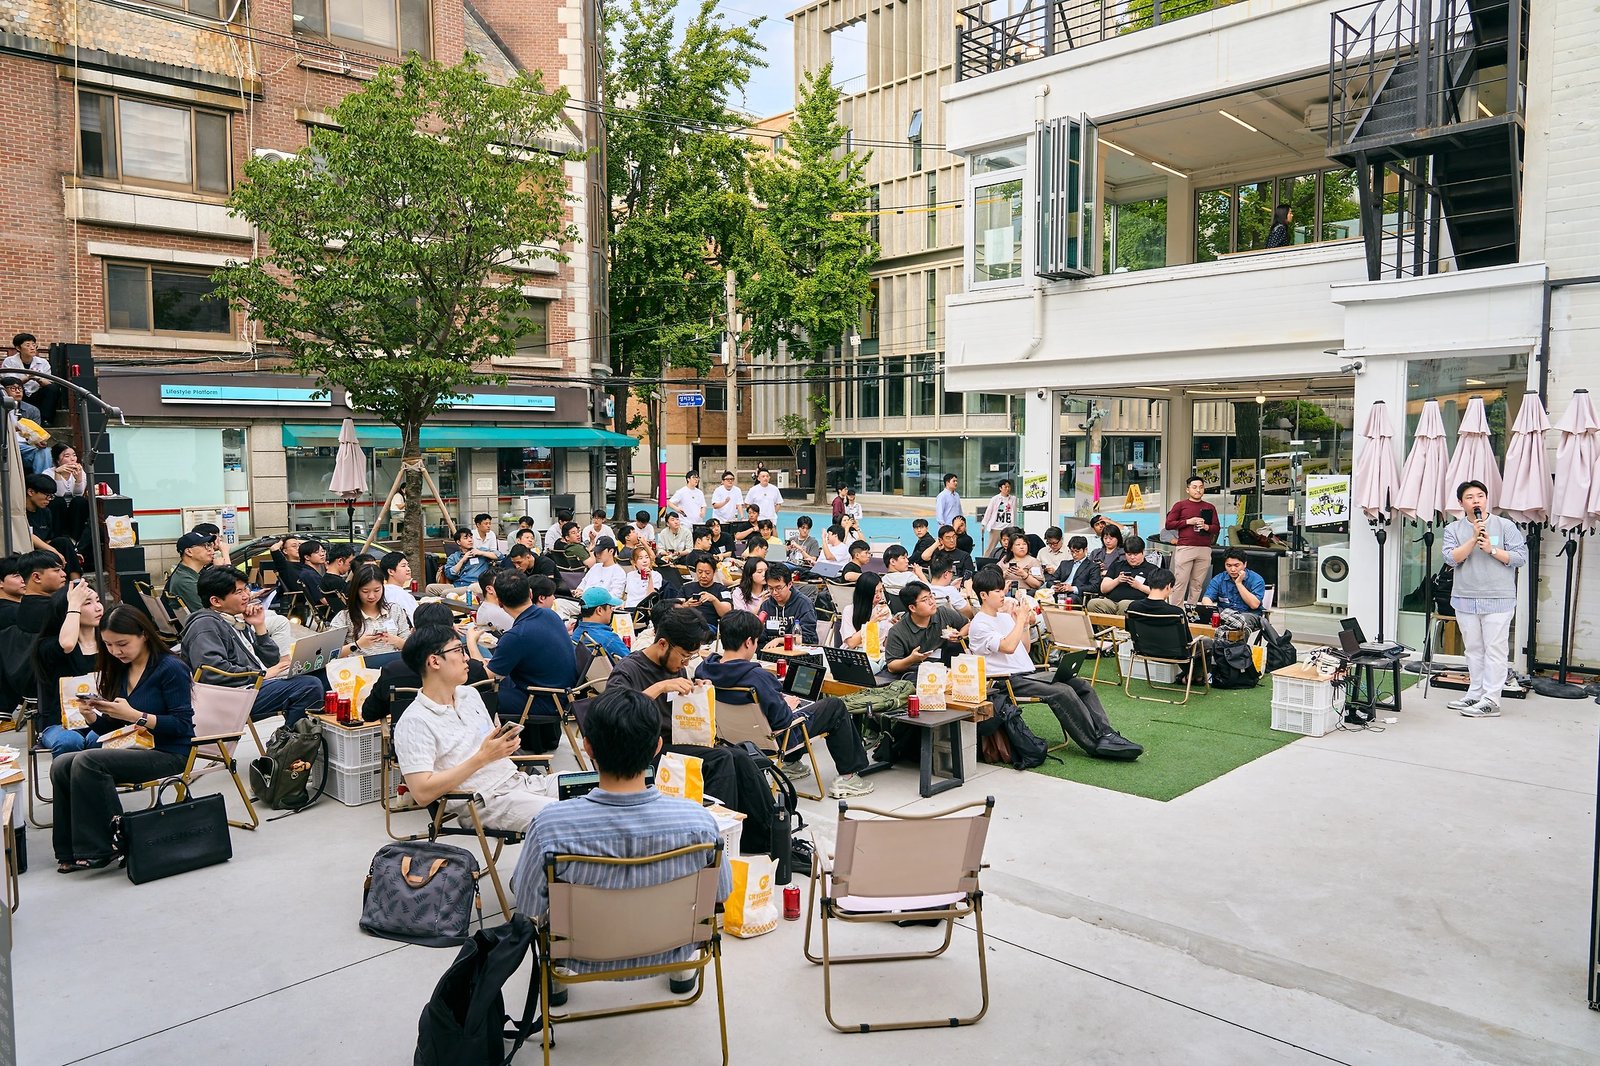
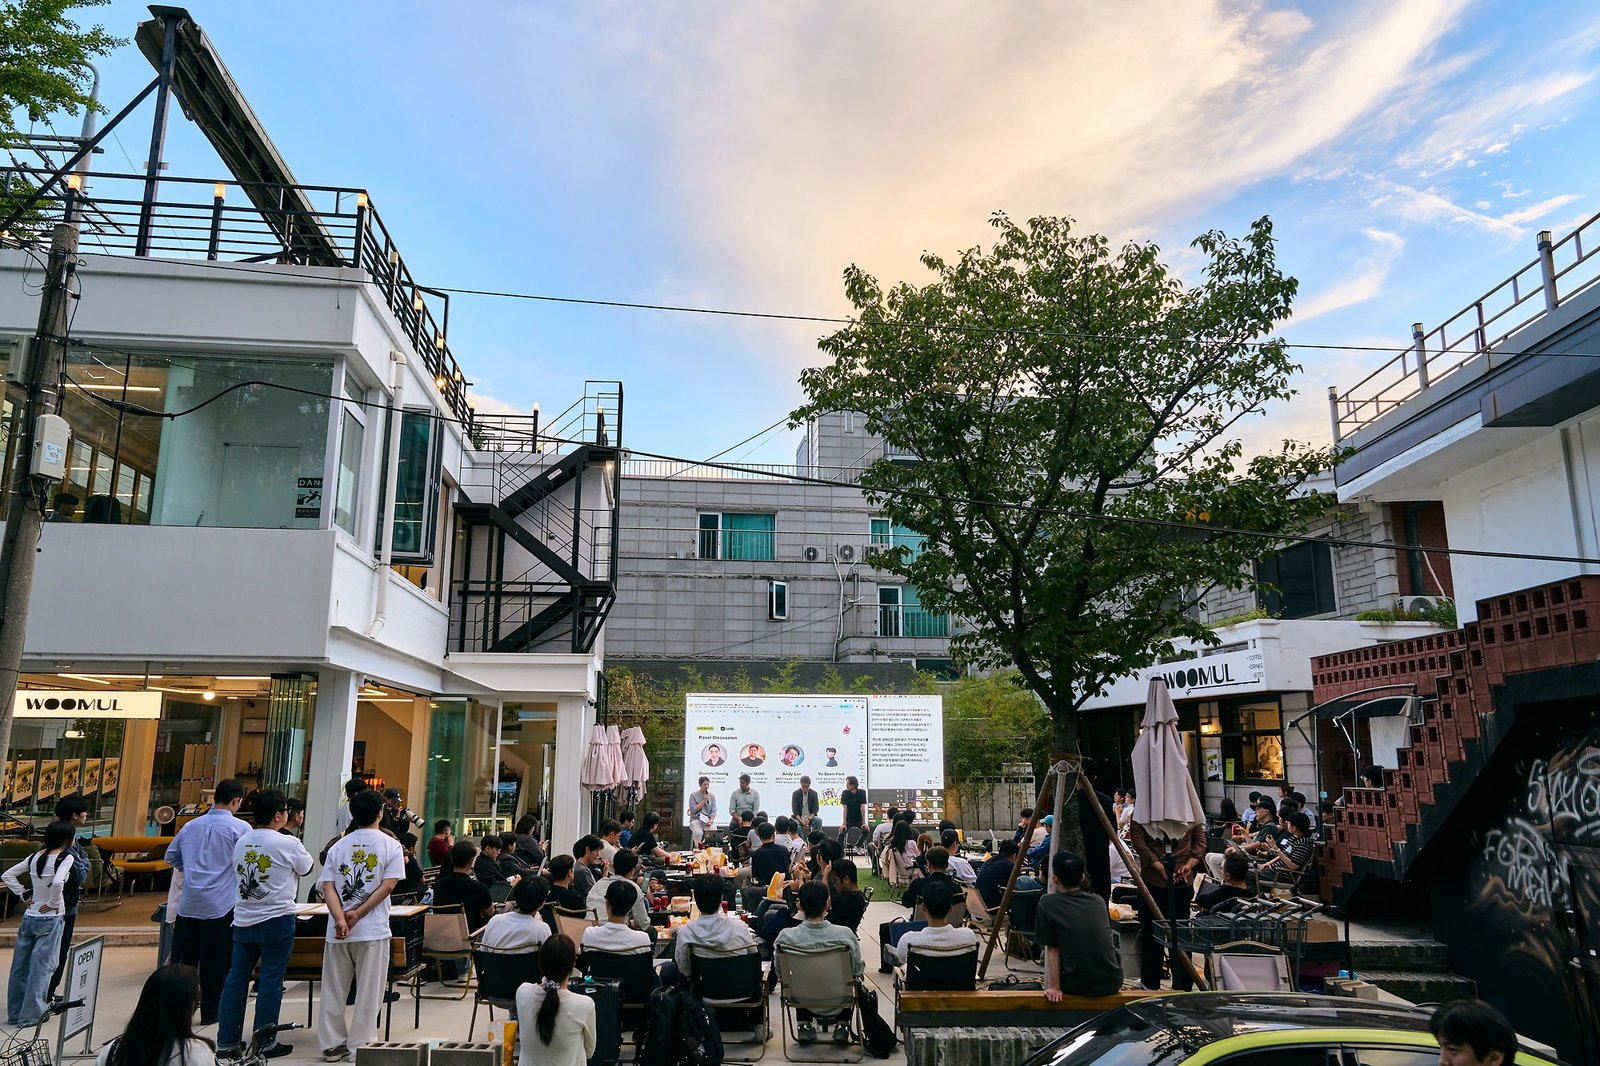
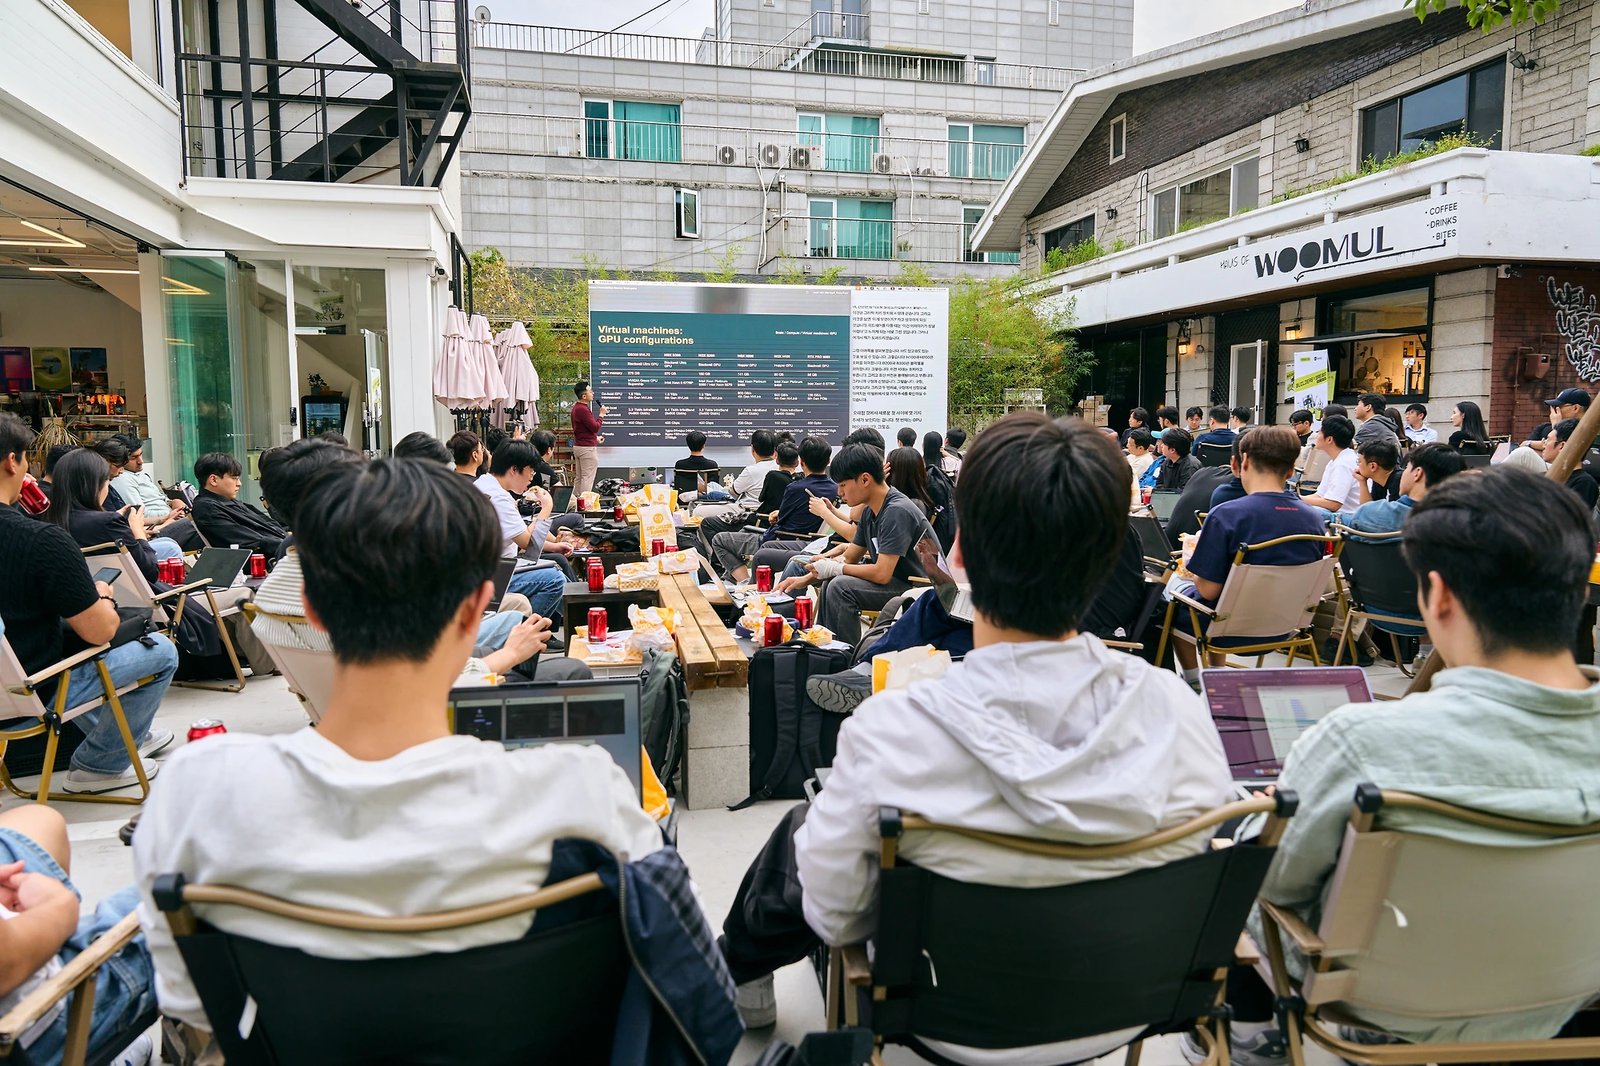
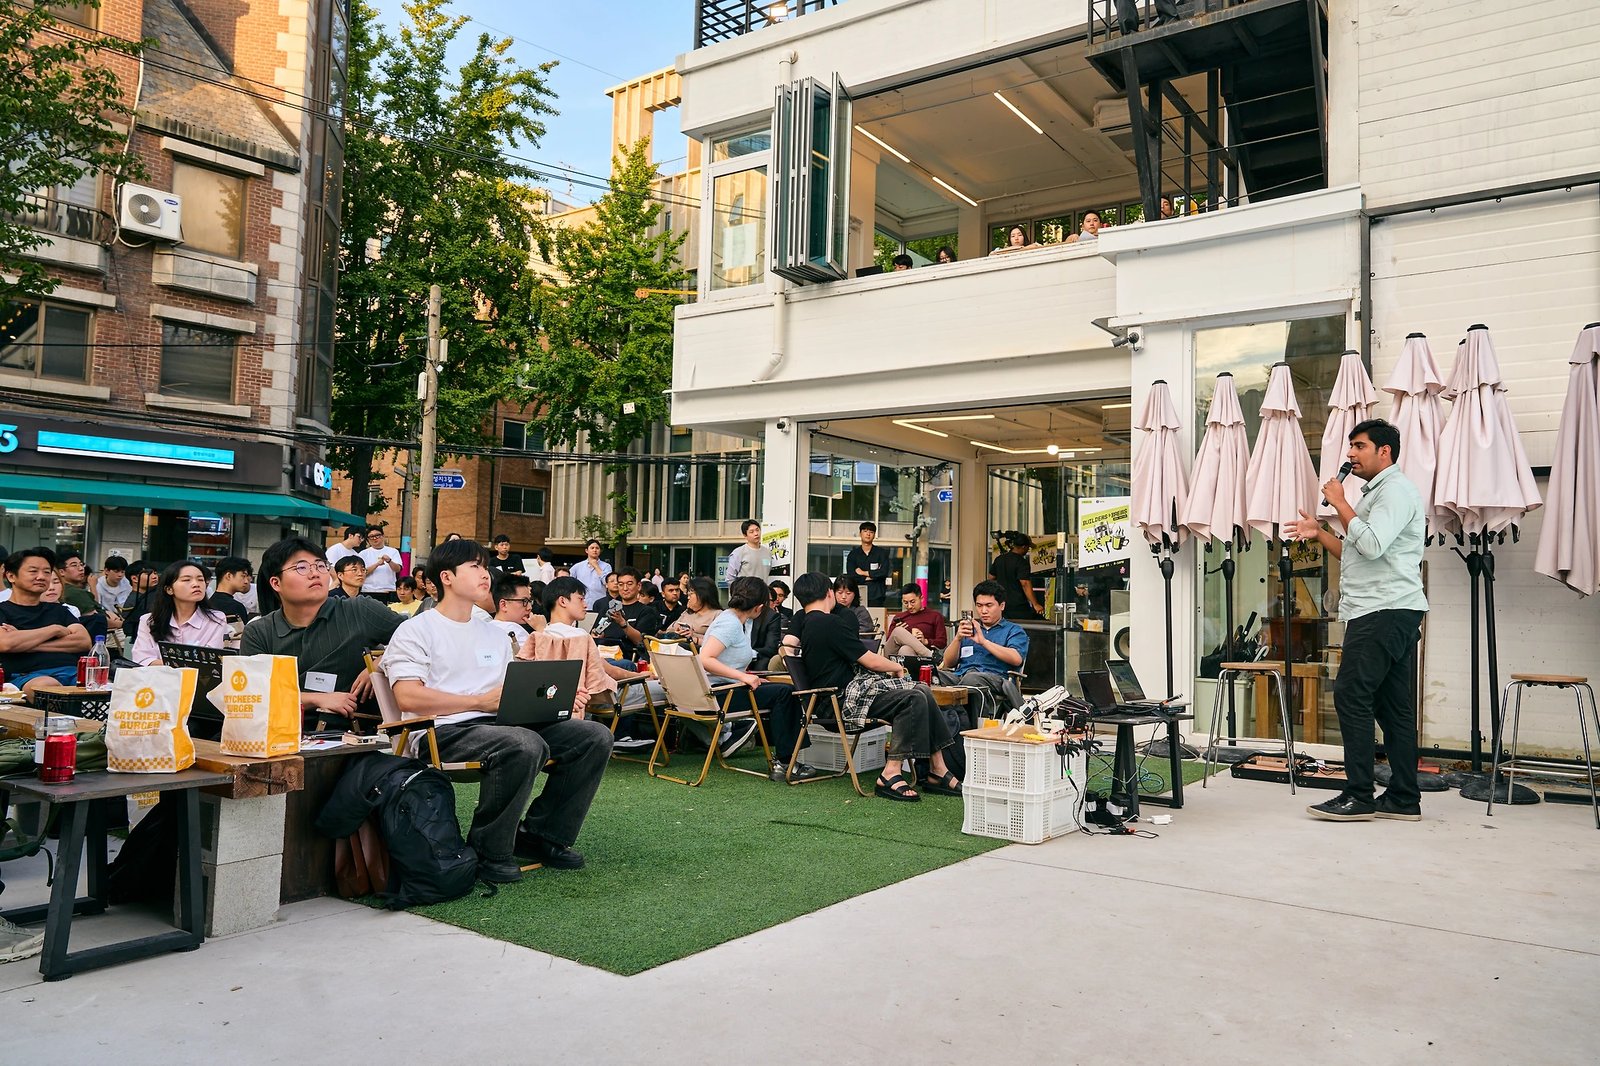
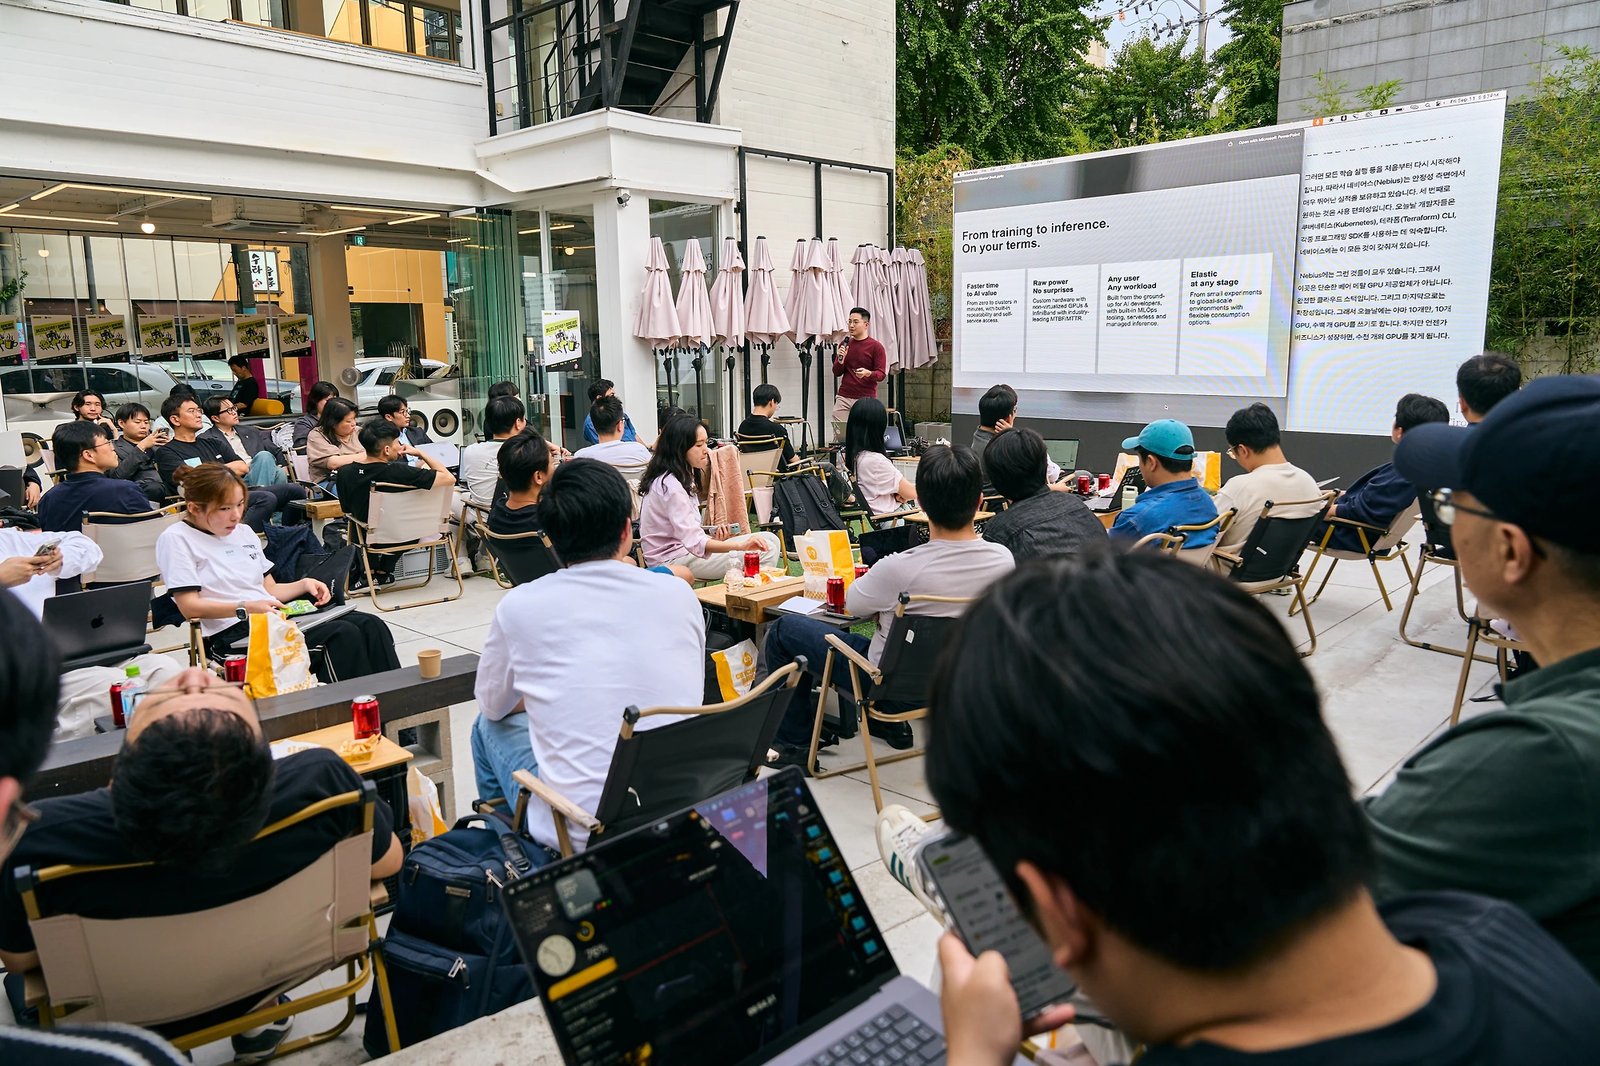
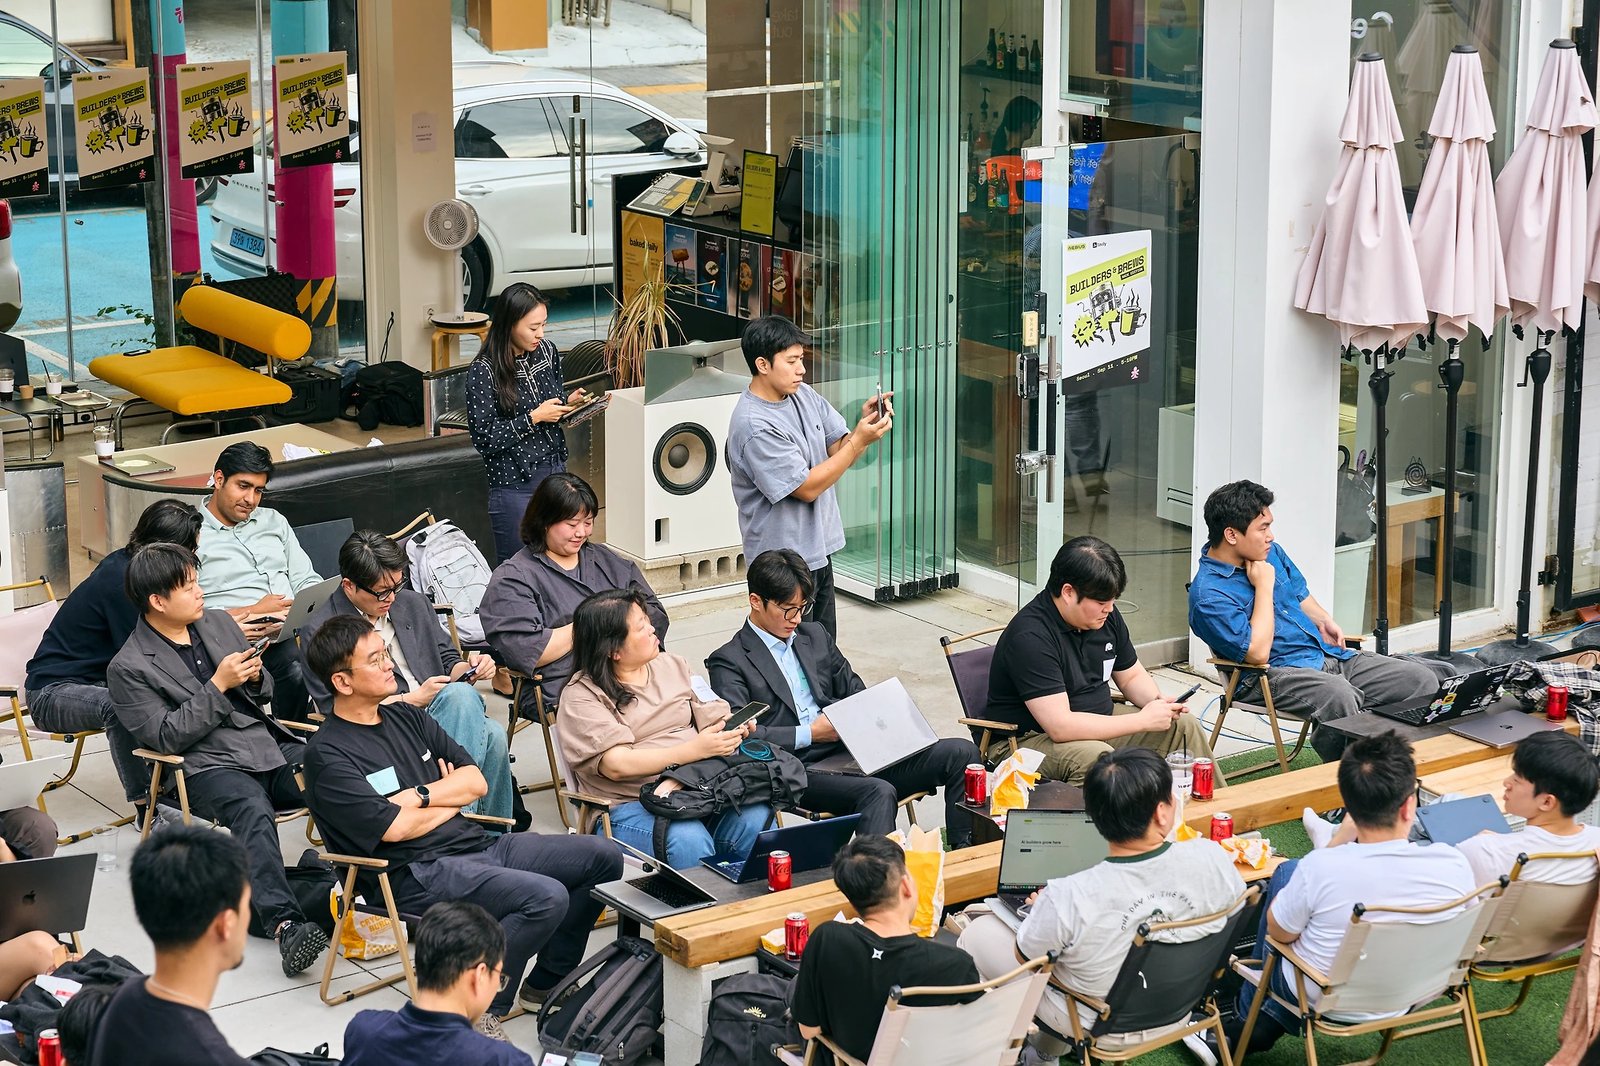
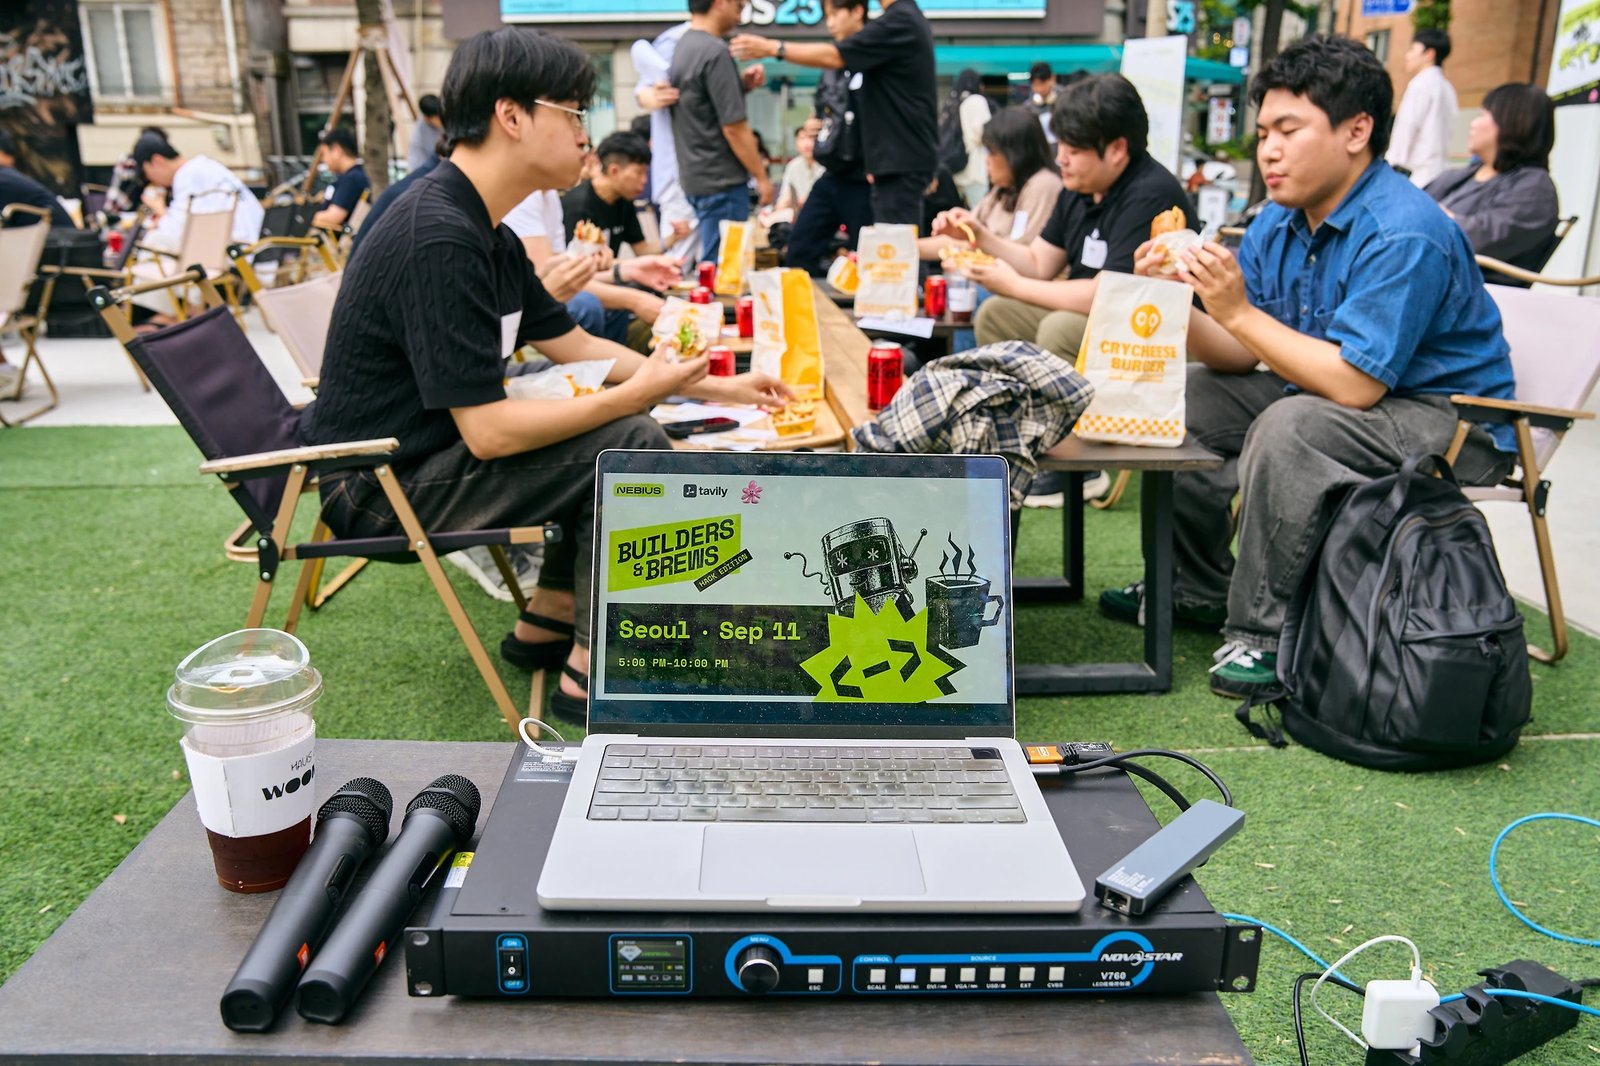
행사장은 합정의 복합문화공간 우물이었습니다. 200평 규모에 야외 마당과 실내 2층, 3층, 옥상까지 있는 곳인데 이날은 통째로 빌렸습니다. Bloom은 보통 강의실 같은 곳에서 모이고 바로 전날에도 다른 기업과 실내에서 행사를 했지만, 해커톤의 출발을 알리는 자리라 조금 다른 공간을 골랐습니다. 금요일 저녁 퇴근길과 겹치는데도 5시 체크인부터 사람들이 일찍 모였고, 먼저 저녁을 먹으며 인사를 나누다가 5시 반에 시작했습니다. Bloom에 처음 오신 분이 4분의 1쯤이었고 전날 행사에서 뵌 얼굴도 여럿 있었습니다.
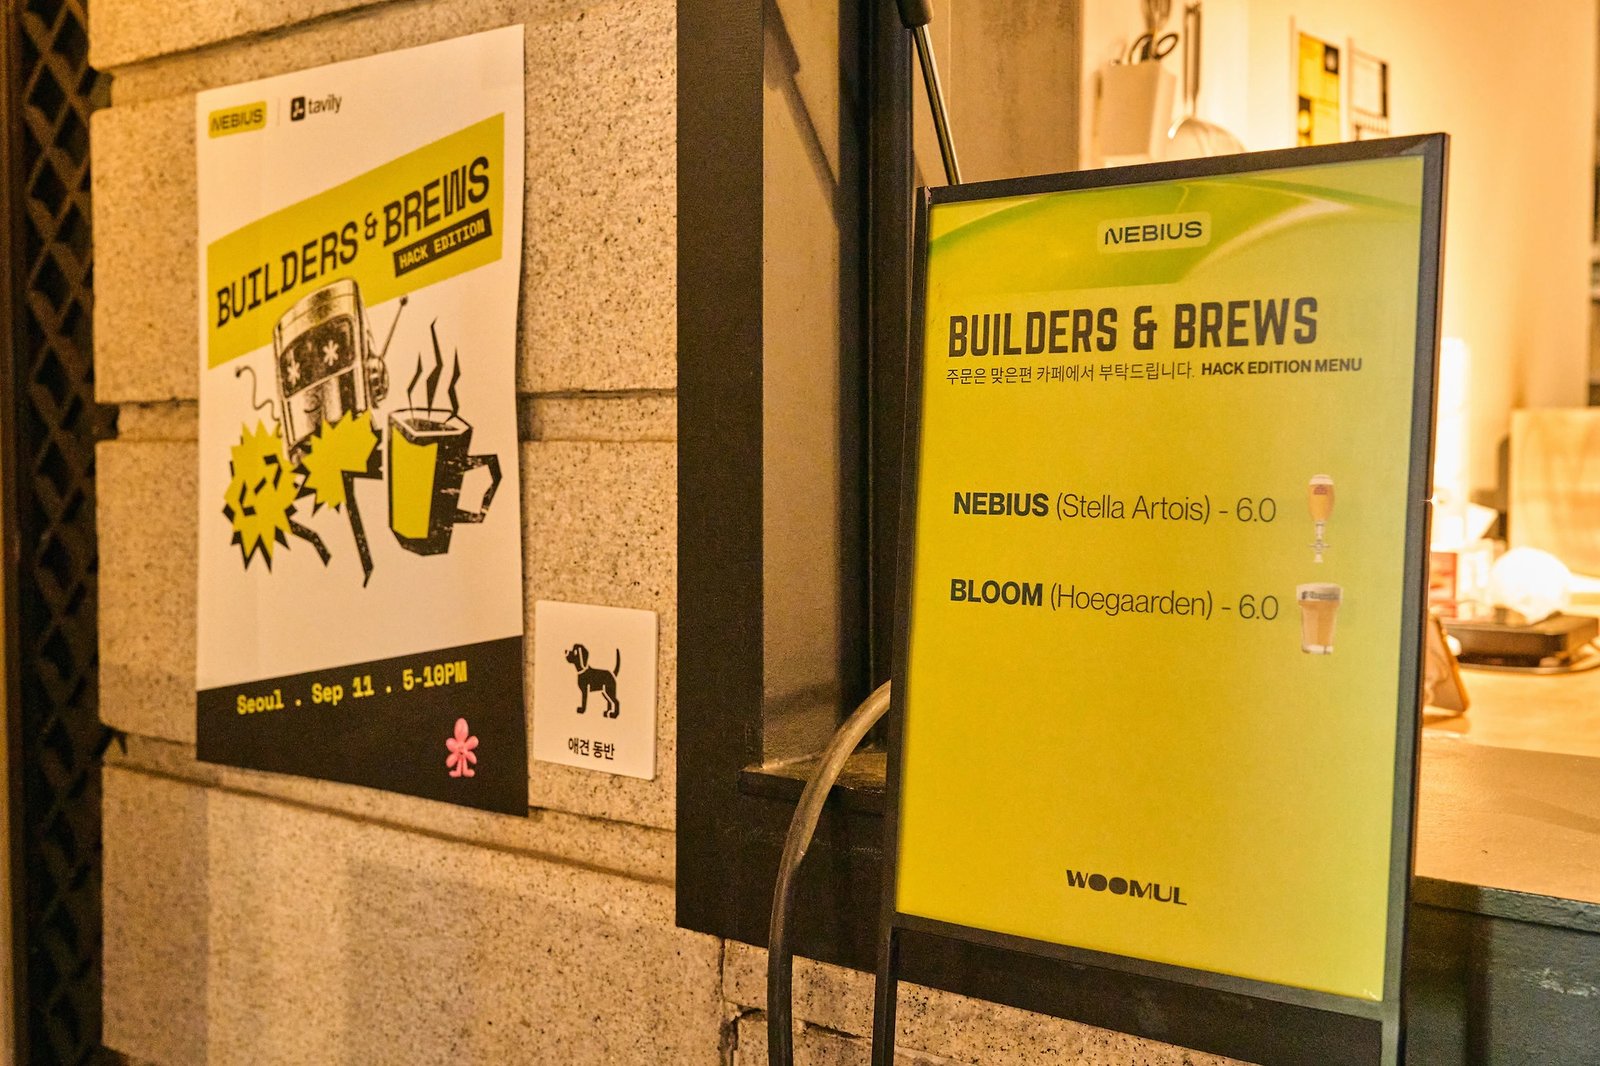
Nebius는 미국 나스닥에 상장된 AI 인프라 회사이고, 이번 해커톤은 Nebius가 NVIDIA와 함께 여는 글로벌 행사입니다. 이틀 전 도쿄를 시작으로 다낭, 서울, 쿠알라룸푸르, 싱가포르, 타이베이를 돌고 런던, 파리, 베를린, 뉴욕, 토론토, 샌프란시스코까지 모두 20개 도시를 거칩니다. 오프닝에서는 준비하며 든 마음을 그대로 이야기했습니다. 20개 도시 가운데 가장 많은 사람이 오고 가장 많이 퍼진 행사로 남기고 싶었다는 것이었습니다.
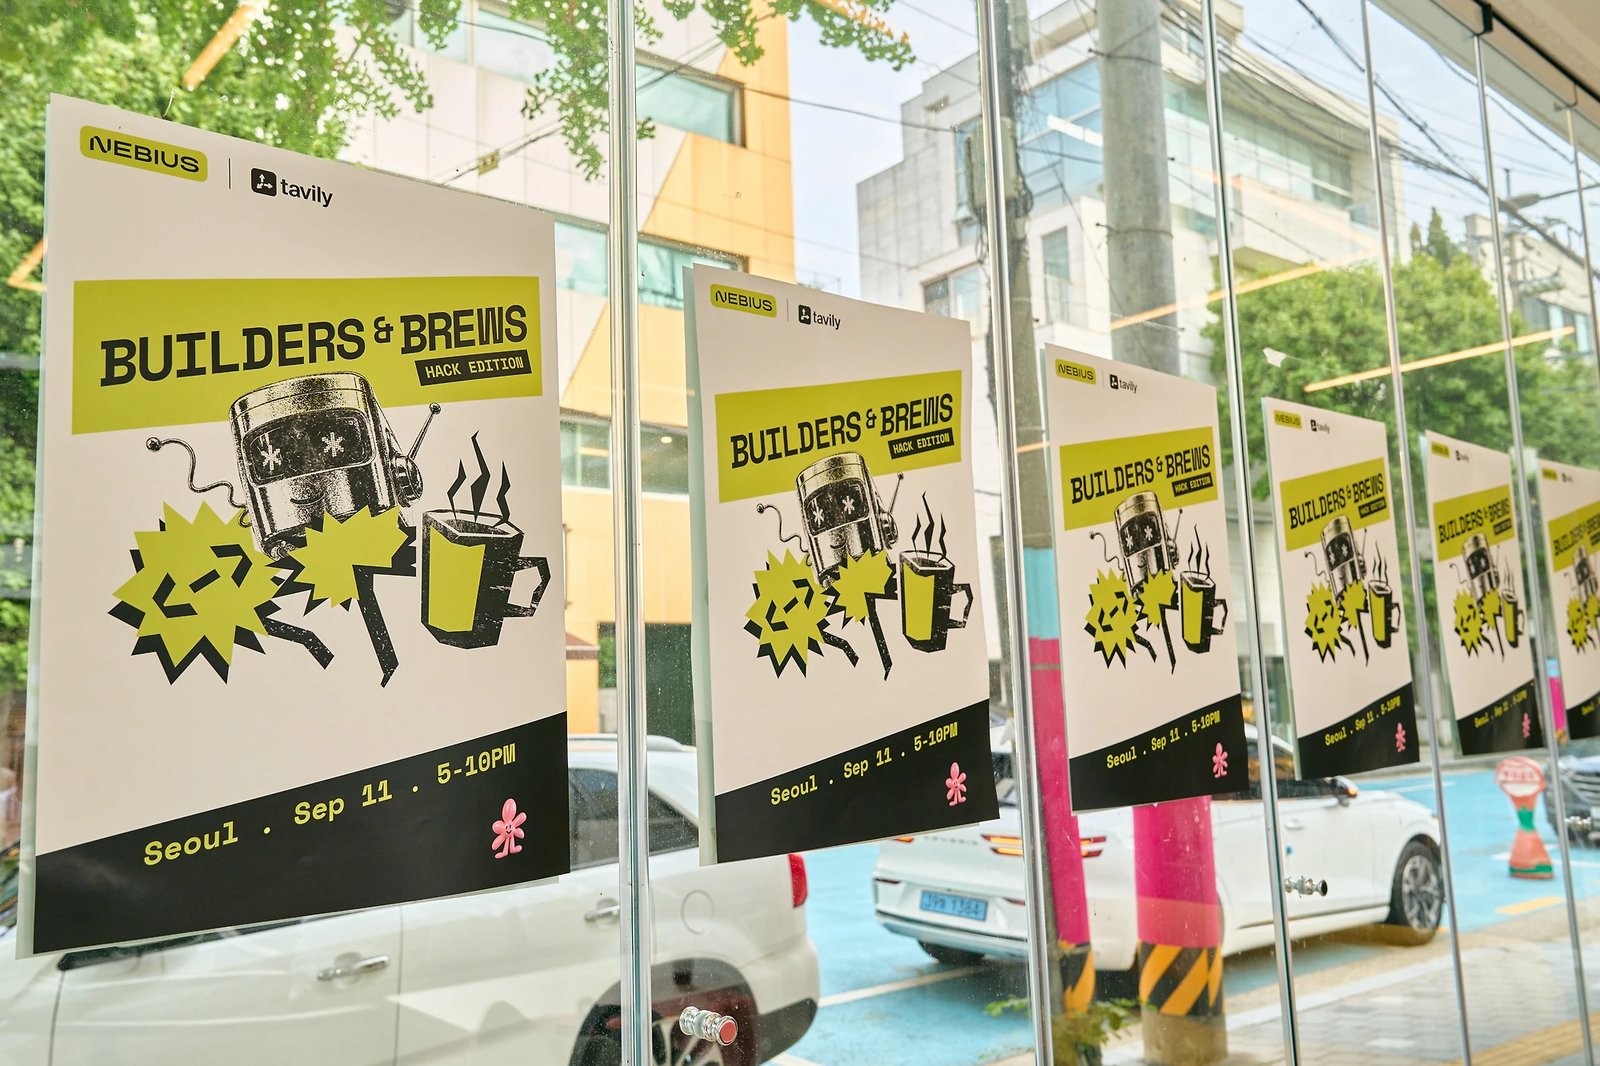
이날은 결과물을 내는 자리가 아니었습니다. 해커톤은 온라인으로 진행되고 제출 마감은 한국 시간으로 10월 31일 새벽 2시입니다. 서울 행사에 오지 않았어도 누구나 참가할 수 있어서 팀을 꾸리고 도구를 익히는 시작점으로 잡았고, 안내에도 데모와 피칭이 없다고 적어두었습니다. 참가하려면 결과물이 Nebius Token Factory나 Nebius AI Cloud 위에서 돌아가야 하고 NVIDIA 오픈소스 모델을 하나 이상 써야 합니다. 트랙은 코딩·에이전틱 엔지니어링, 앱·에이전트, 개인용 AI, 피지컬 AI 네 개입니다. 상금은 모두 5만 달러가 넘고, 트랙별 우승 네 팀은 NVIDIA Jetson Orin Nano를 받습니다. 피지컬 AI 트랙은 제출 영상에 실제 하드웨어나 로봇이 움직이는 장면을 1분 이상 넣어야 하는데, 시뮬레이션 화면만으로는 안 된다는 이 조건이 이날 무대에서 나온 이야기와 그대로 맞닿아 있었습니다.
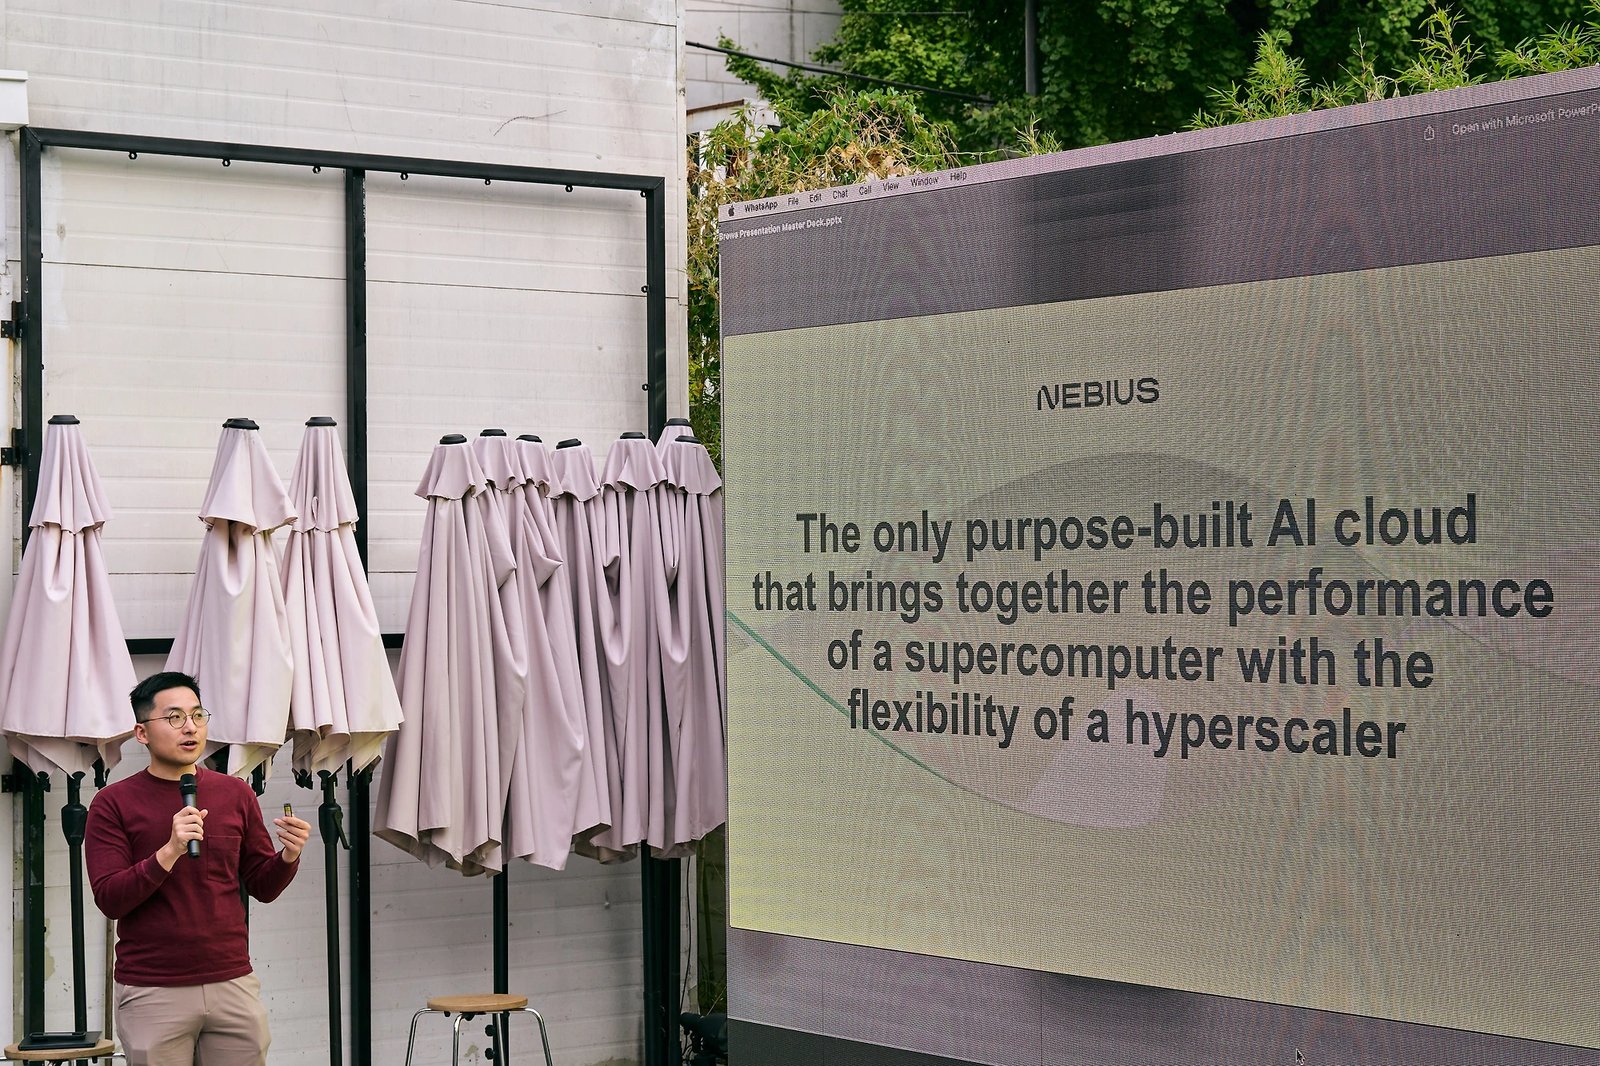
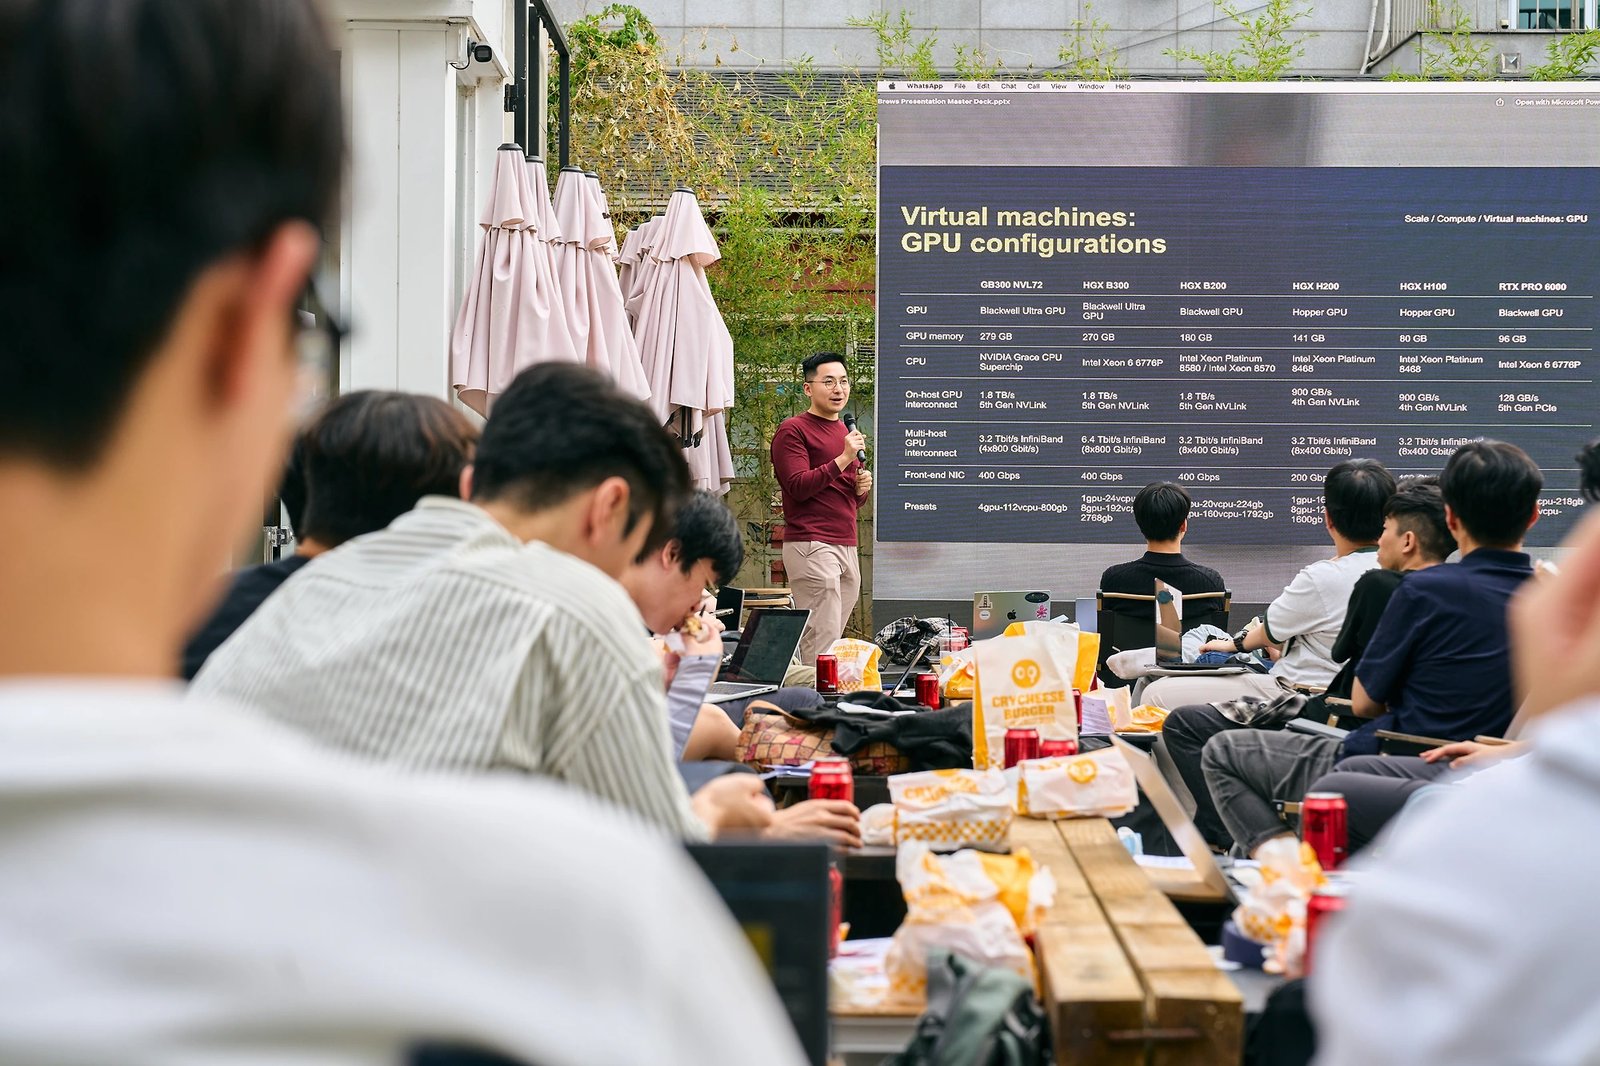
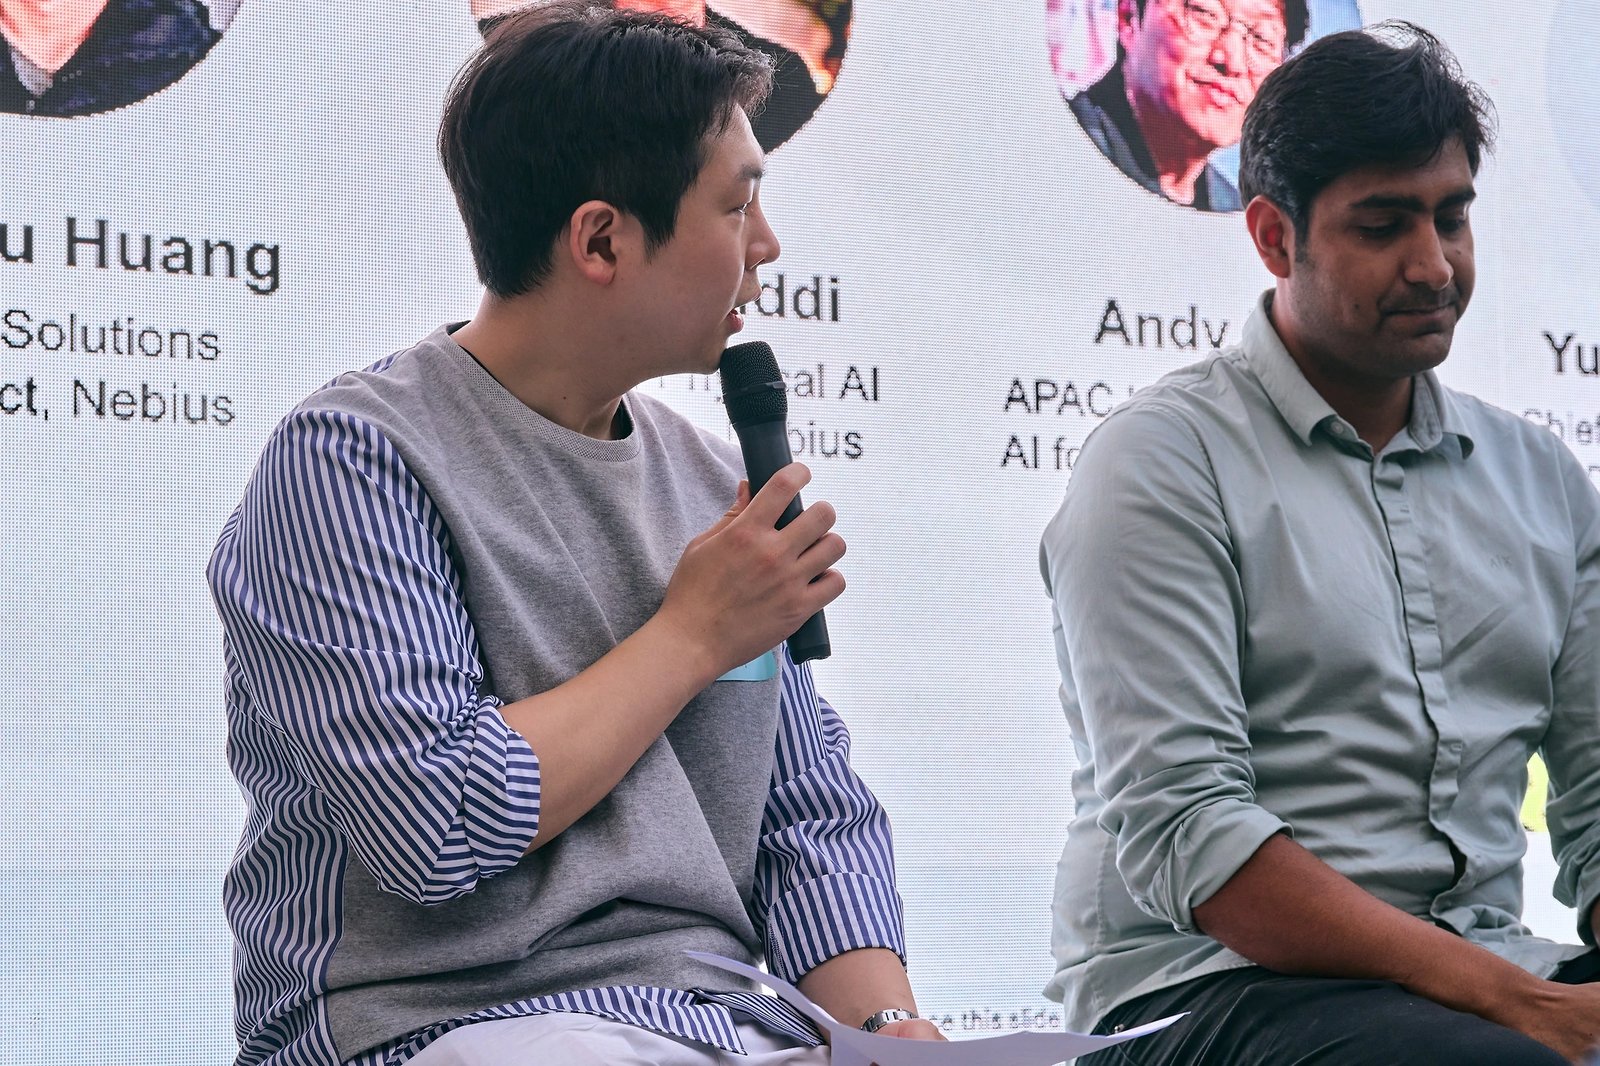
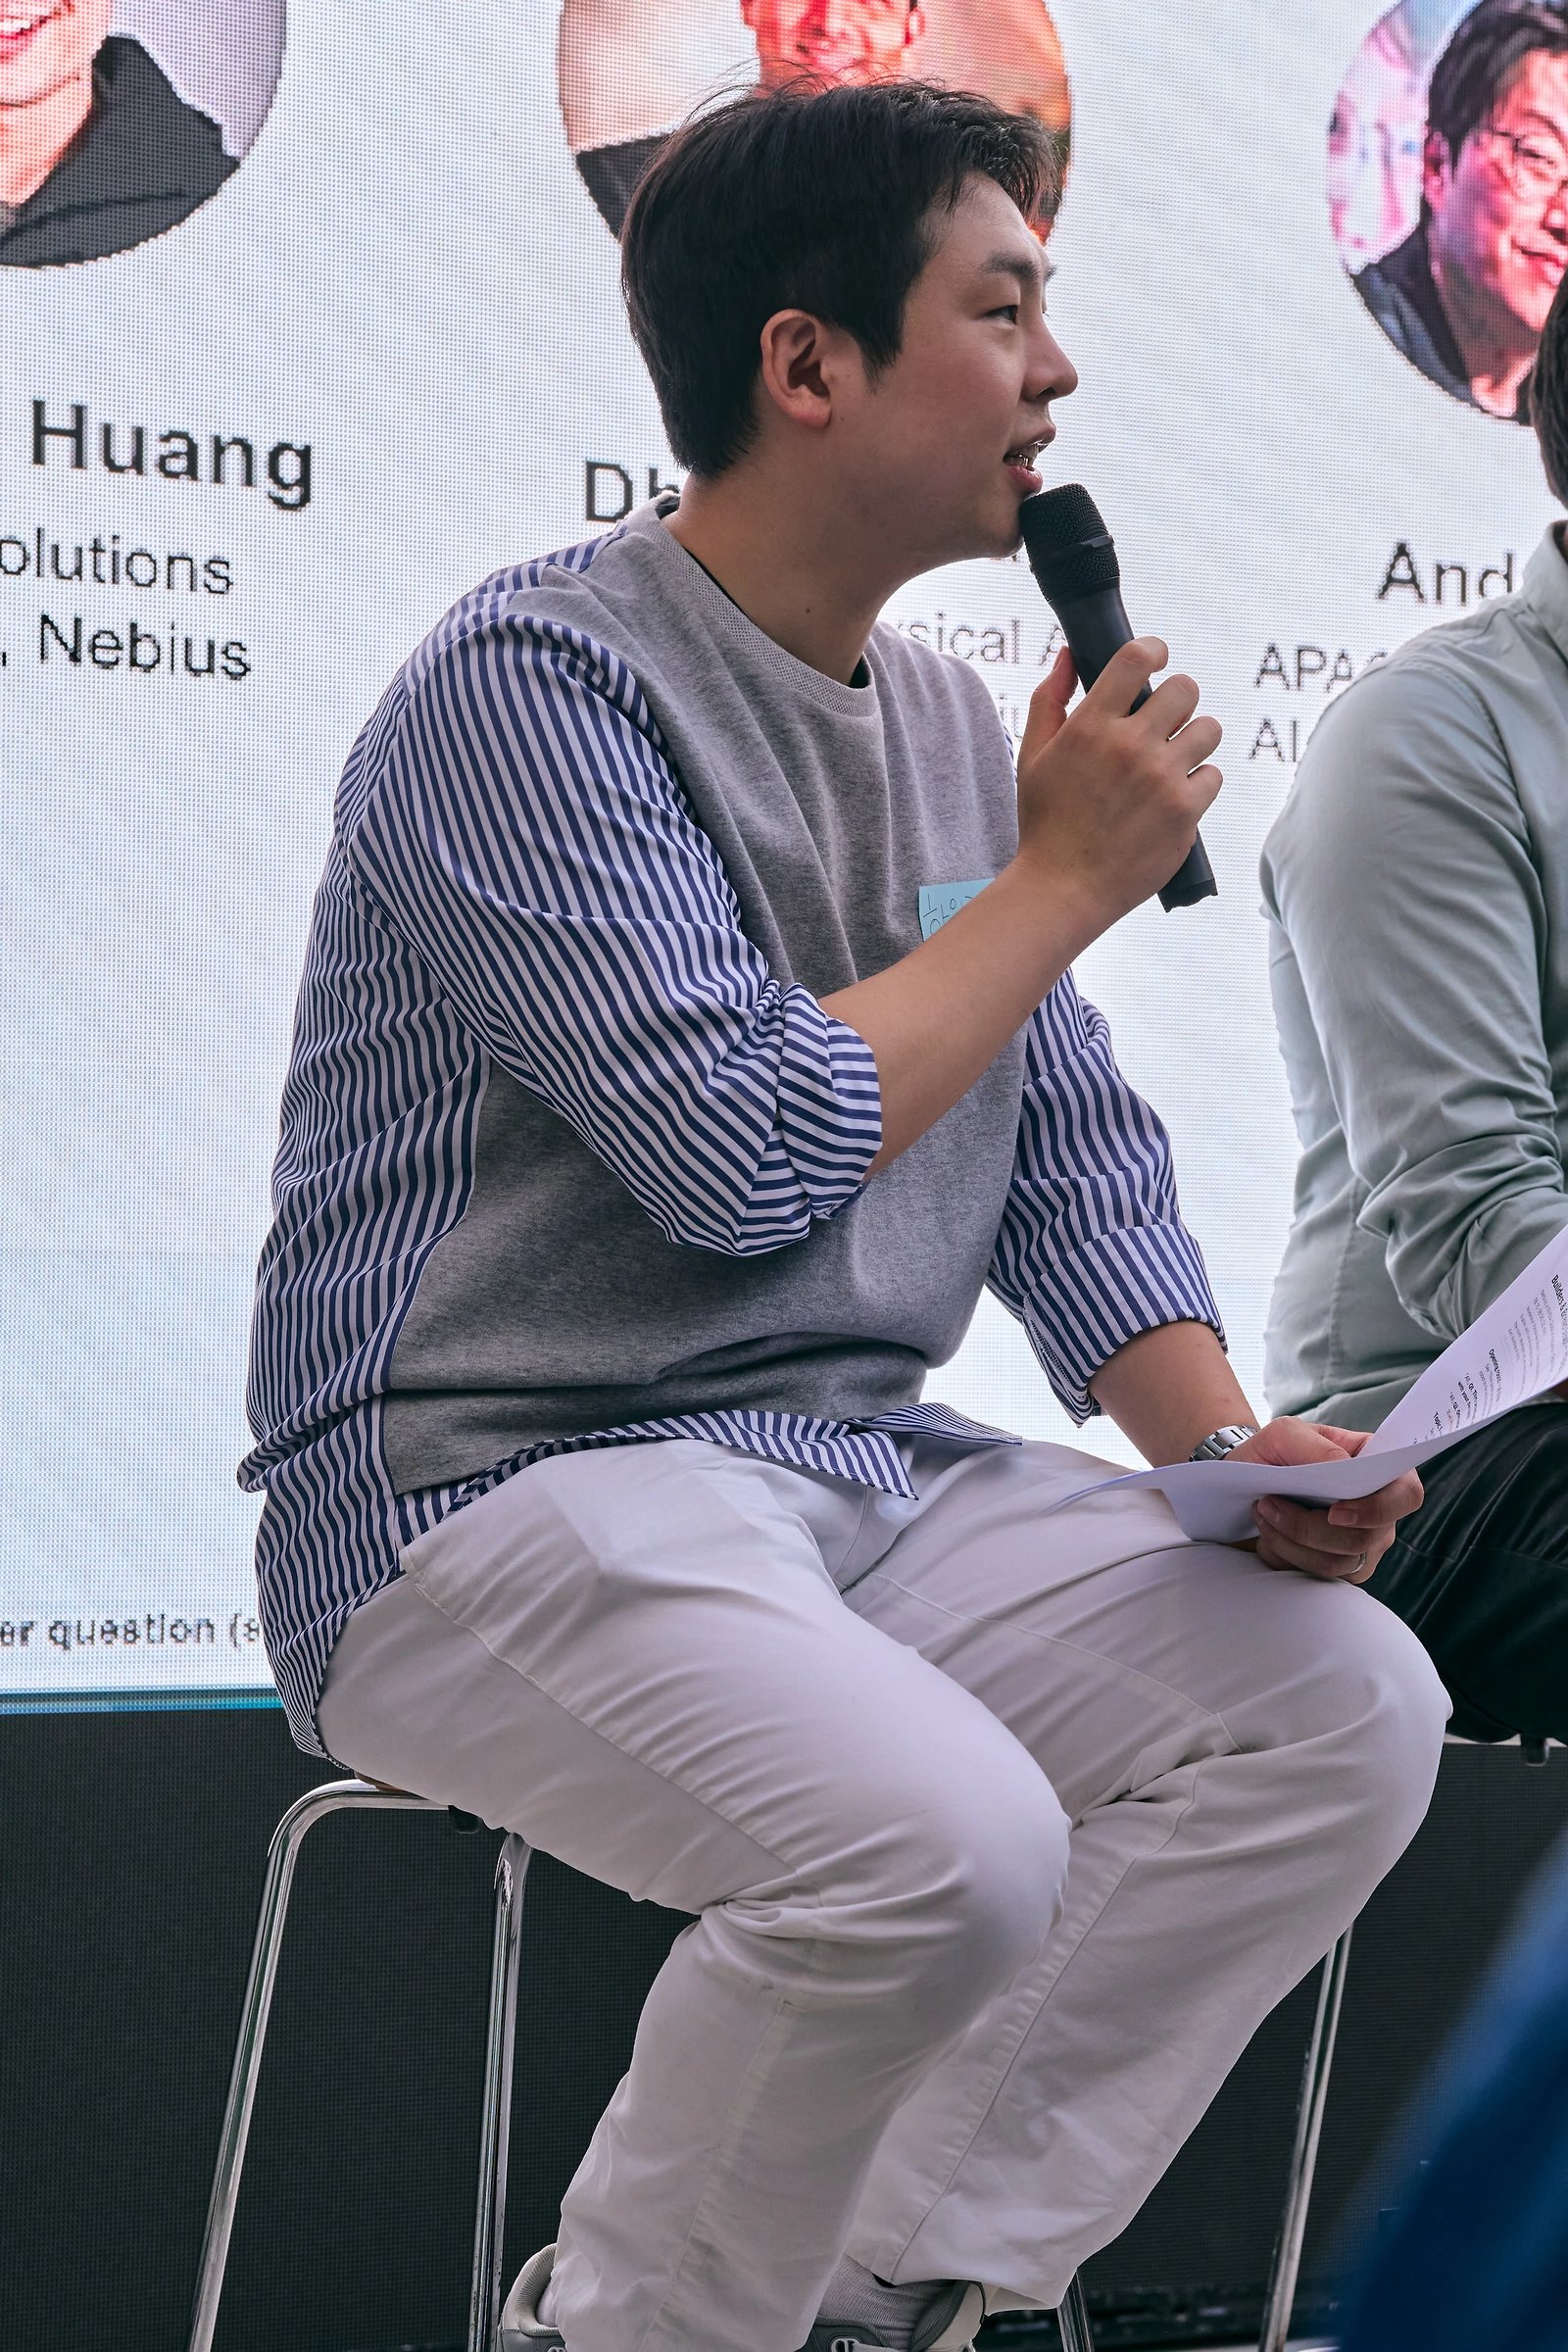
첫 세션은 Nebius의 클라우드 솔루션 아키텍트 Guan-ru Huang 님이었습니다. 대만 출신으로 Nebius에 합류한 지 1년이 넘었고 일본과 한국을 포함한 아시아 전역을 맡습니다. 가장 먼저 꺼낸 것은 선물이었습니다. 추론 플랫폼 Token Factory에서 쓸 수 있는 100달러 크레딧과, Nebius가 최근 인수한 Tavily의 크레딧 1,000이었습니다. 기존에 폐쇄형 API를 쓰고 있다면 같은 방식의 엔드포인트로 오픈소스 모델에 바로 옮겨 탈 수 있다고 했습니다. Nebius를 들어본 적 있느냐는 질문에는 손이 하나도 올라오지 않았는데, 오히려 좋다며 웃었습니다.
Nebius가 강조한 것은 주가가 아니라 구조였습니다. NVIDIA의 전략적 파트너로서 NVIDIA 레퍼런스 아키텍처대로 데이터센터를 짓고, 하드웨어와 데이터센터와 소프트웨어 스택을 모두 직접 만드는 수직 통합이라는 점입니다. 업계를 두 부류로 나눠 설명했습니다. 하이퍼스케일러는 데이터센터를 지을 때 AI가 아니라 범용 워크로드를 염두에 뒀고, 반대편의 GPU 임대 업체는 소프트웨어 스택 없이 GPU만 빌려줍니다. Nebius는 그 사이에서 처음부터 AI 워크로드용으로 데이터센터를 짓고 그 위에 클라우드 소프트웨어까지 얹은 쪽이라고 했습니다.
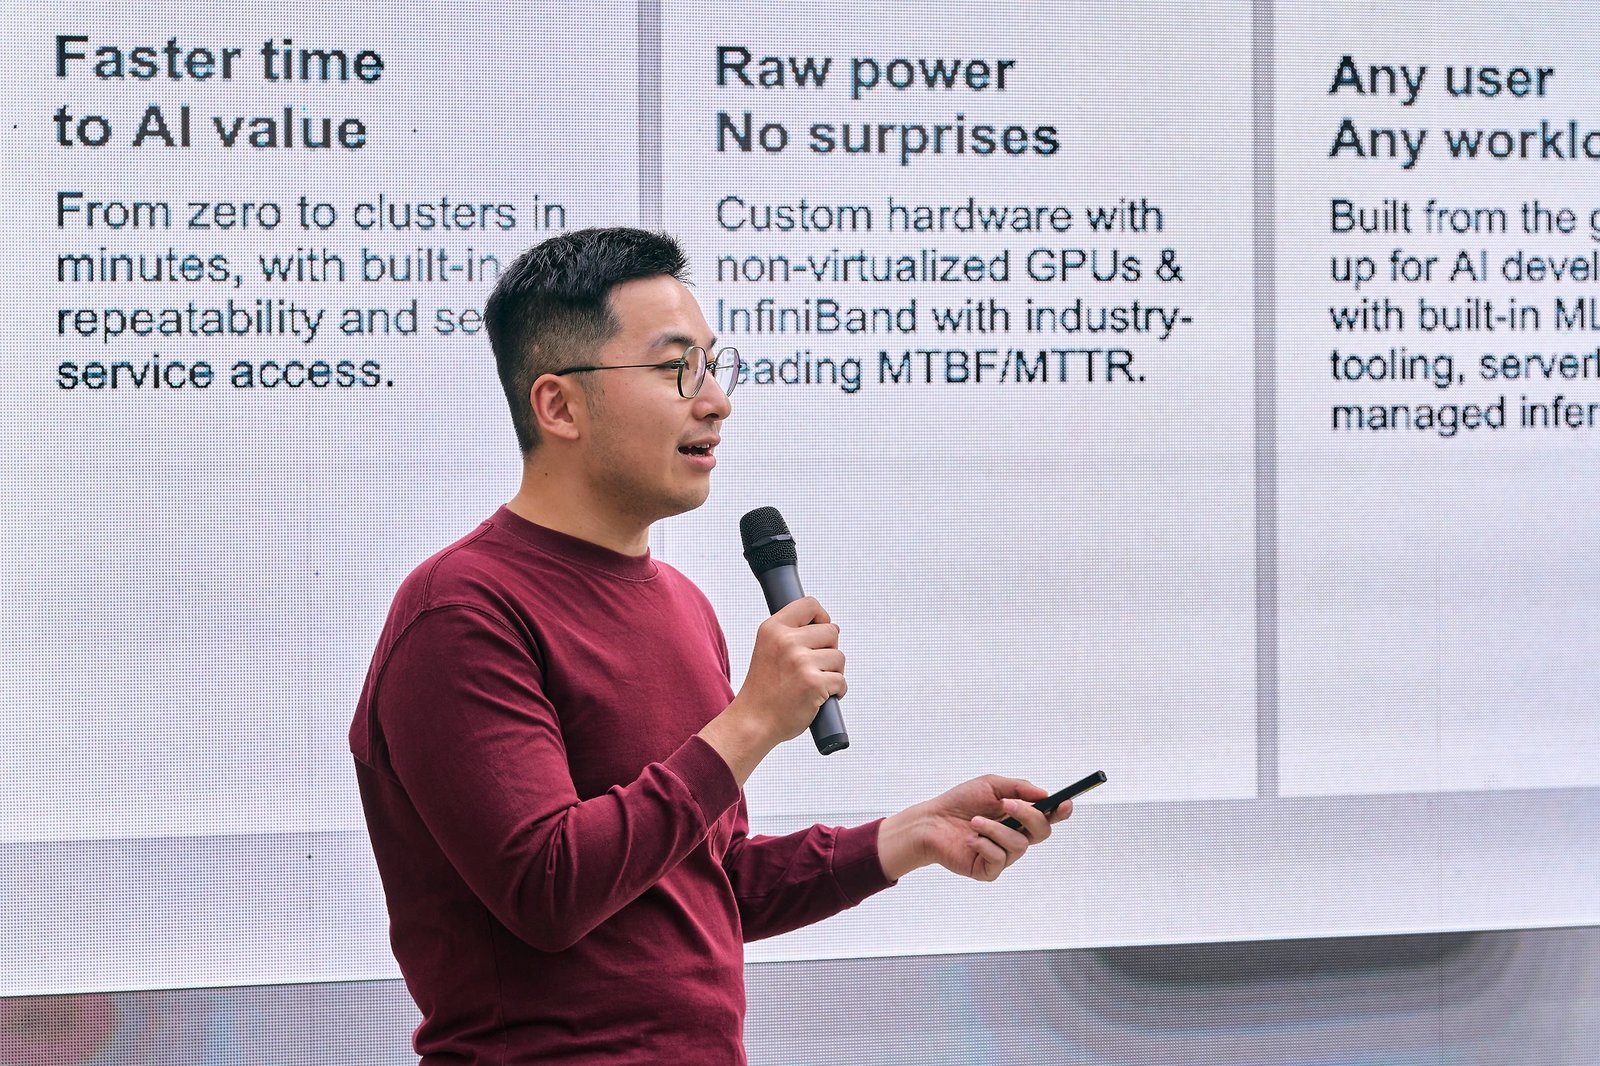
고객이 GPU를 구할 때 가장 먼저 보는 것은 확보 속도라고 했습니다. AI 스타트업에게 최악은 용량을 못 구하는 상황이고, 채용은 됐는데 모델을 학습시킬 GPU가 없으면 ML 과학자들이 패닉에 빠진다는 것입니다. 요즘 모델은 주 단위와 월 단위로 학습을 돌려서 중간에 클러스터가 끊기면 처음부터 다시 해야 하니 안정성을 보고, 익숙한 도구를 그대로 쓸 수 있는지를 봅니다. GPU 열 개로 시작해도 사업이 크면 수천 개가 필요해지니 같은 클러스터 안에서 함께 커질 수 있는지도 따집니다. 하드웨어 얘기는 비개발자도 알아듣게 풀었습니다. GPU 클라우드의 세 재료인 컴퓨트와 스토리지와 네트워킹을 인프라 회사의 지방과 탄수화물과 단백질이라고 불렀습니다.
GPU를 쓰는 방식도 층이 나뉩니다. 가장 쉬운 것은 서버리스로, VM도 쿠버네티스도 관리할 필요 없이 컨테이너만 올리면 됩니다. 인프라를 직접 다루고 싶은 팀에게는 Slurm을 쿠버네티스 위에서 돌리는 오픈소스 오퍼레이터가 있습니다. 요즘 ML 과학자는 박사과정 연구실에서 일찍부터 Slurm 스크립트를 써왔고, 클라우드에서 온 DevOps 엔지니어는 Terraform과 쿠버네티스는 익숙해도 Slurm은 전혀 모릅니다. 한 회사에 이 두 사람이 같이 있으니 두 가지 클러스터를 함께 준다는 설명이 구체적이었습니다.
다음은 관리형 추론 플랫폼 Token Factory였습니다. 지금 개발자들은 대개 폐쇄형 API를 쓰거나 직접 호스팅하는데, 폐쇄형은 처음이 가장 쉽지만 서비스가 커질수록 비용이 불어나 마진이 줄고, 셀프호스팅은 추론 클러스터를 돌릴 전담 팀이 필요합니다. 더 큰 문제로 짚은 것은 두 방식 모두 내 서비스의 트래픽 데이터로 모델을 계속 고칠 기회를 주지 않는다는 점이었습니다. Token Factory는 그 고리를 제품 안에 넣었습니다. 오픈소스 모델로 추론을 시작하고, 트래픽 데이터를 내보내 고객이 실제로 무엇을 묻는지 본 다음 다시 post-training을 하고, 그렇게 만든 커스텀 가중치를 원하는 GPU 타입과 리전에 전용 엔드포인트로 올립니다. 추론 플랫폼은 많지만 자기 AI 클라우드를 가진 곳은 드물어서 다른 곳에서는 GPU 타입도 서빙 리전도 고를 수 없다는 점을 강조했습니다.
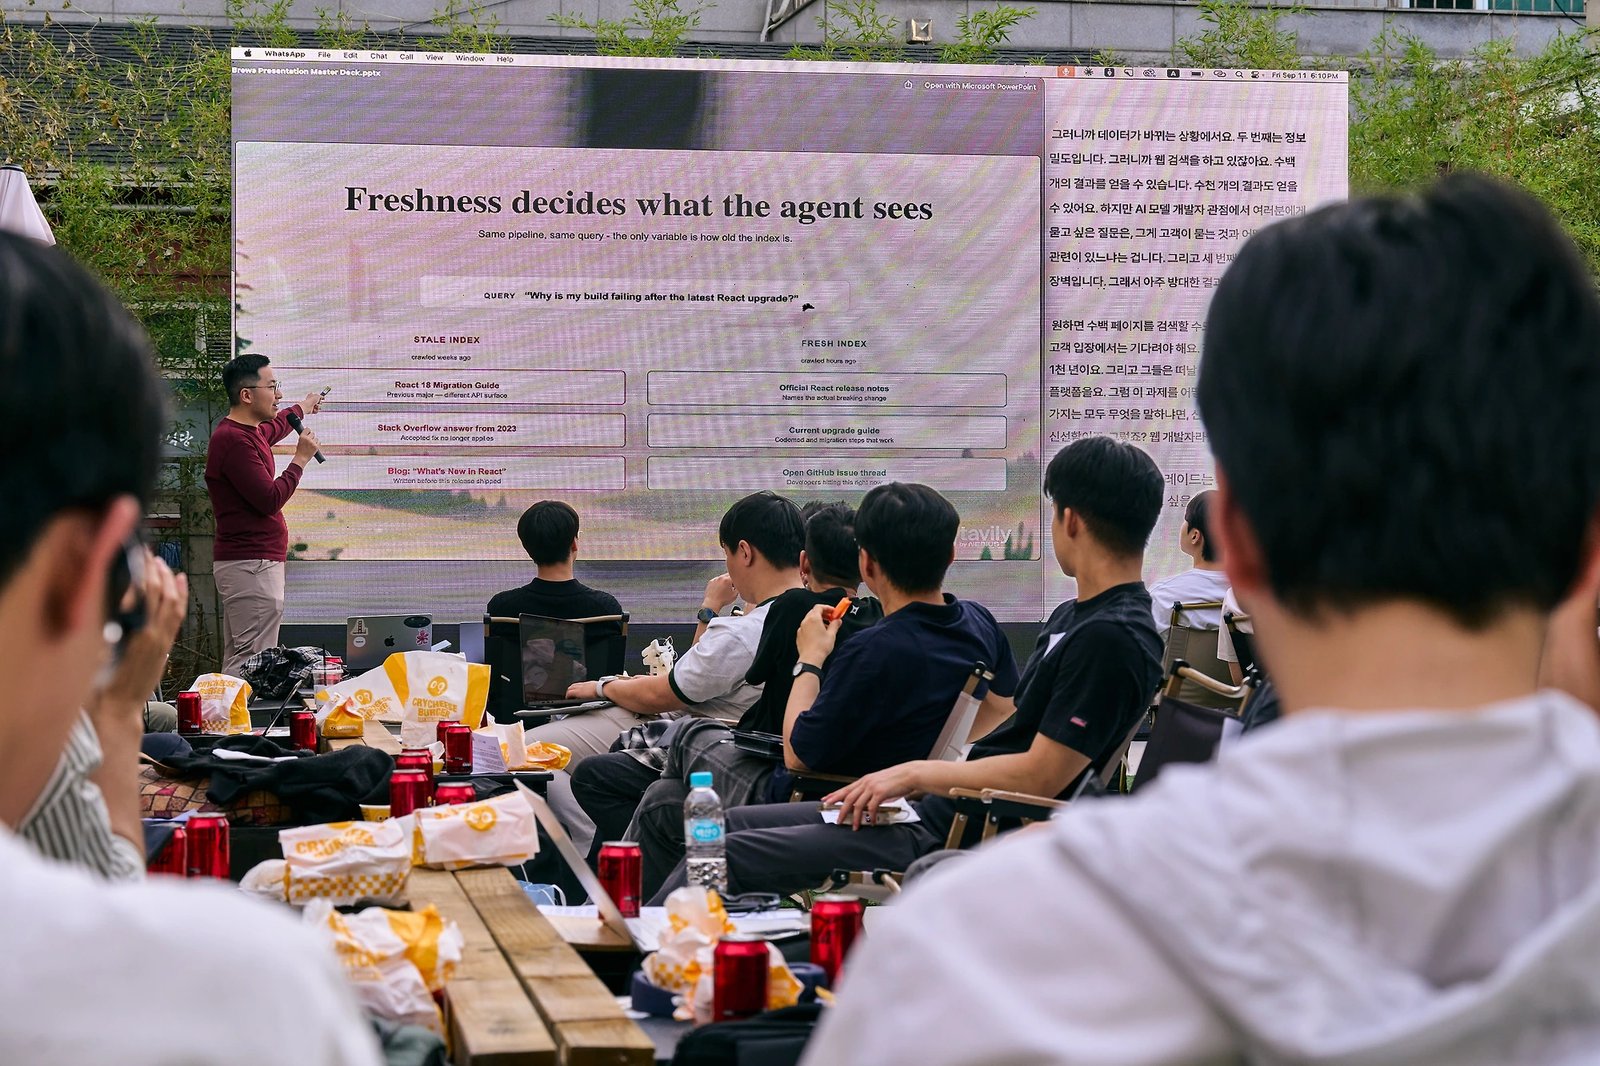
마지막은 Tavily였습니다. 지금 몇 점이냐고 물으면 모델은 웹에서 답을 가져와야 하는데, 2초 전에 일어난 일을 학습한 모델은 어디에도 없습니다. 그런데 웹 검색 결과는 AI 에이전트가 읽기 어려운 형태로 돌아옵니다. Tavily는 에이전트와 웹 사이에 끼는 계층으로, 관련 URL 목록을 주는 search와 URL 안의 내용을 뽑아주는 extract와 URL 사이의 관계를 따라가는 crawl을 제공합니다. 풀어야 할 문제는 정확도와 관련성과 속도 셋인데, 이를 관통하는 것이 최신성이라고 했습니다. 최신 업그레이드가 왜 안 되느냐는 질문에 2~3년 전 문서를 가져오면 쓸모가 없습니다. 그래서 페이지가 얼마나 자주 바뀌는지, 마지막 업데이트가 언제인지, 얼마나 자주 검색되는지, 사이트가 얼마나 중요한지 네 가지 신호를 점수 하나로 합쳐 그 사이트를 다음에 언제 다시 긁을지 정합니다.
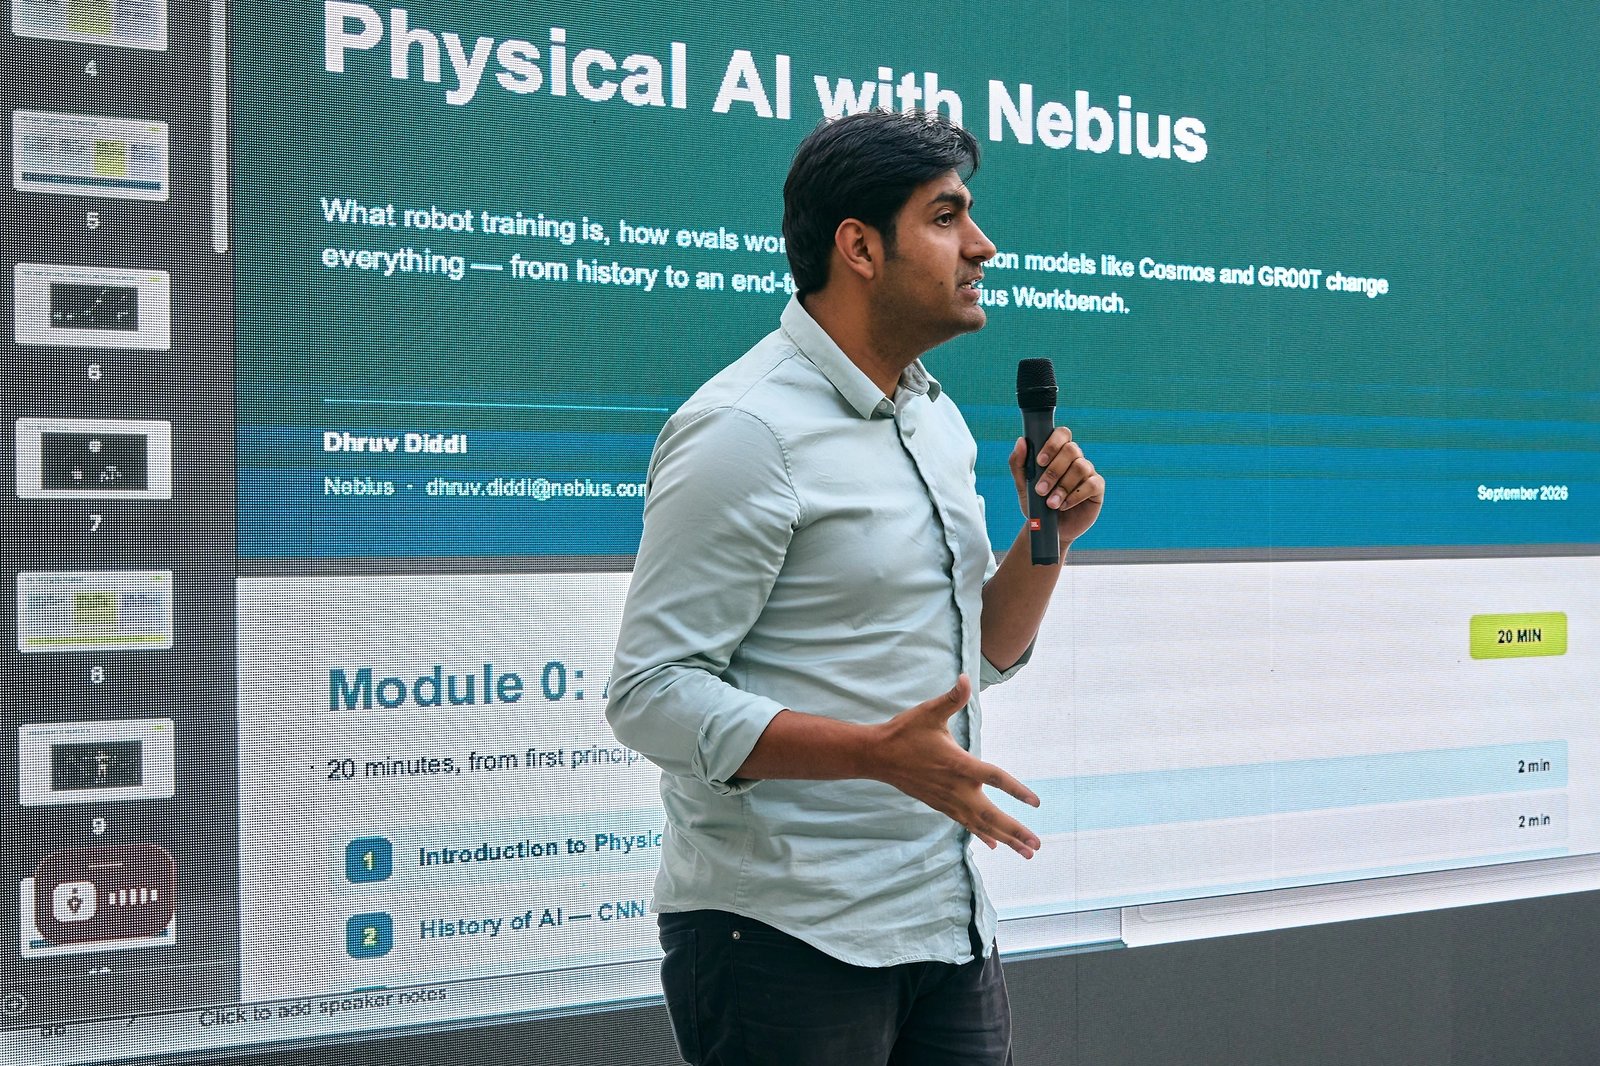
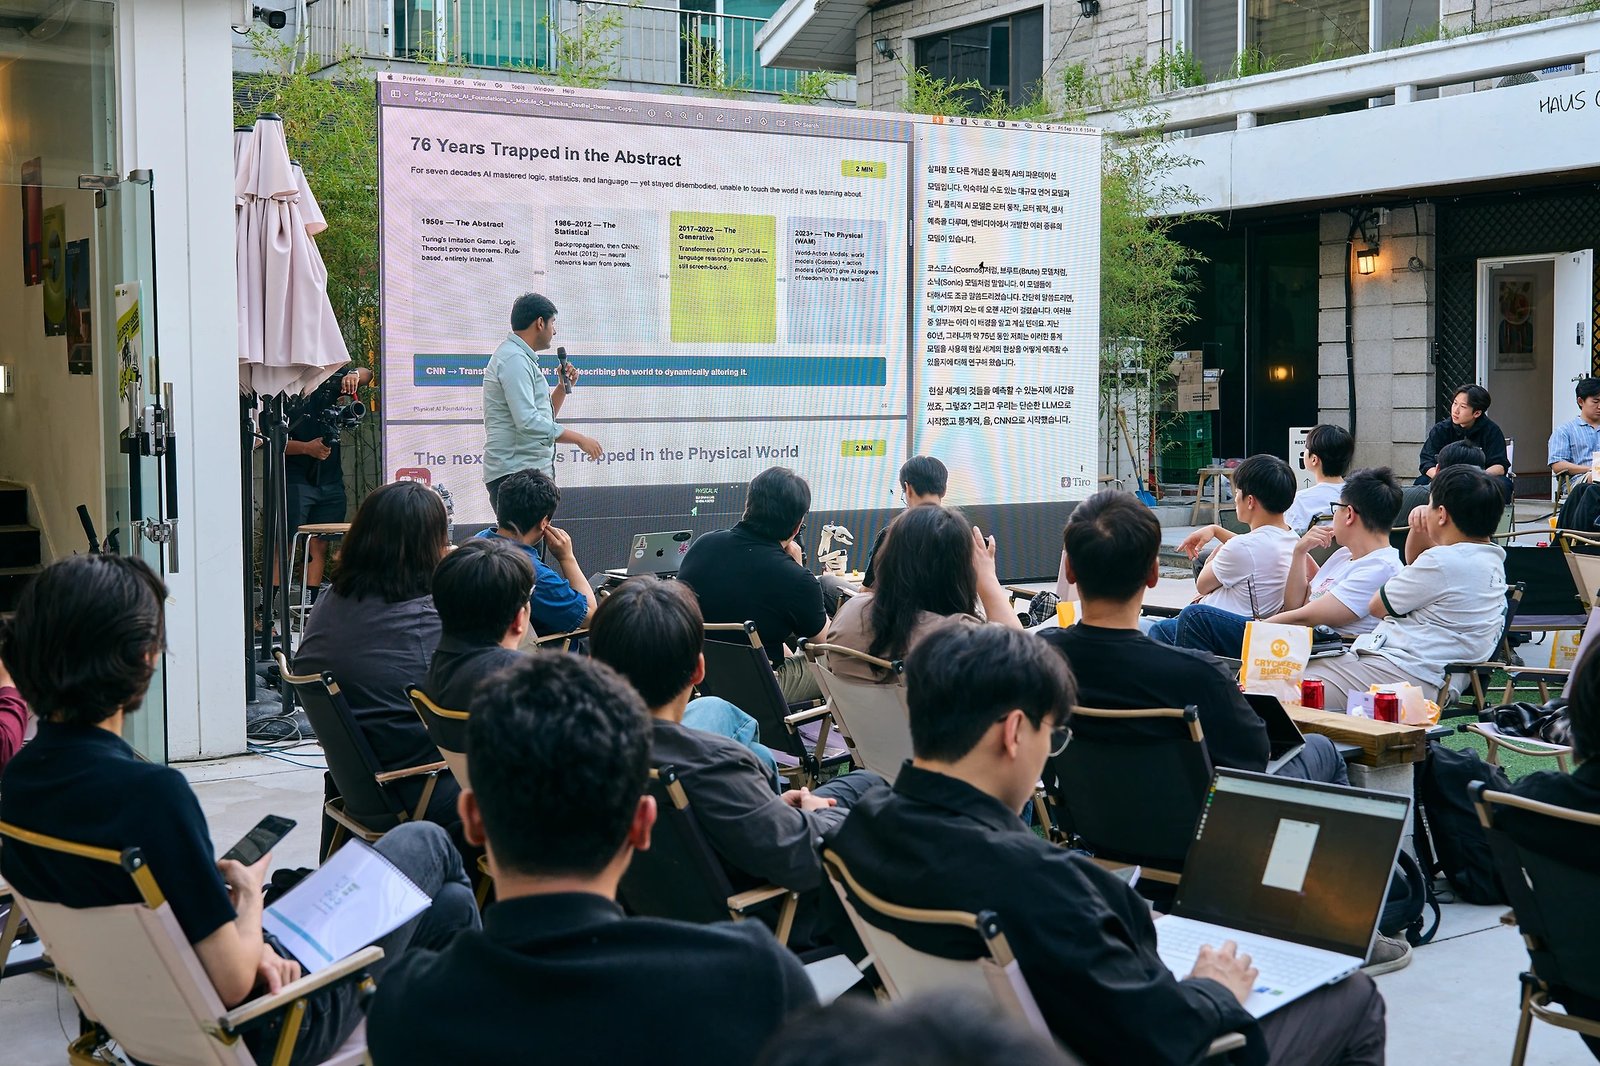
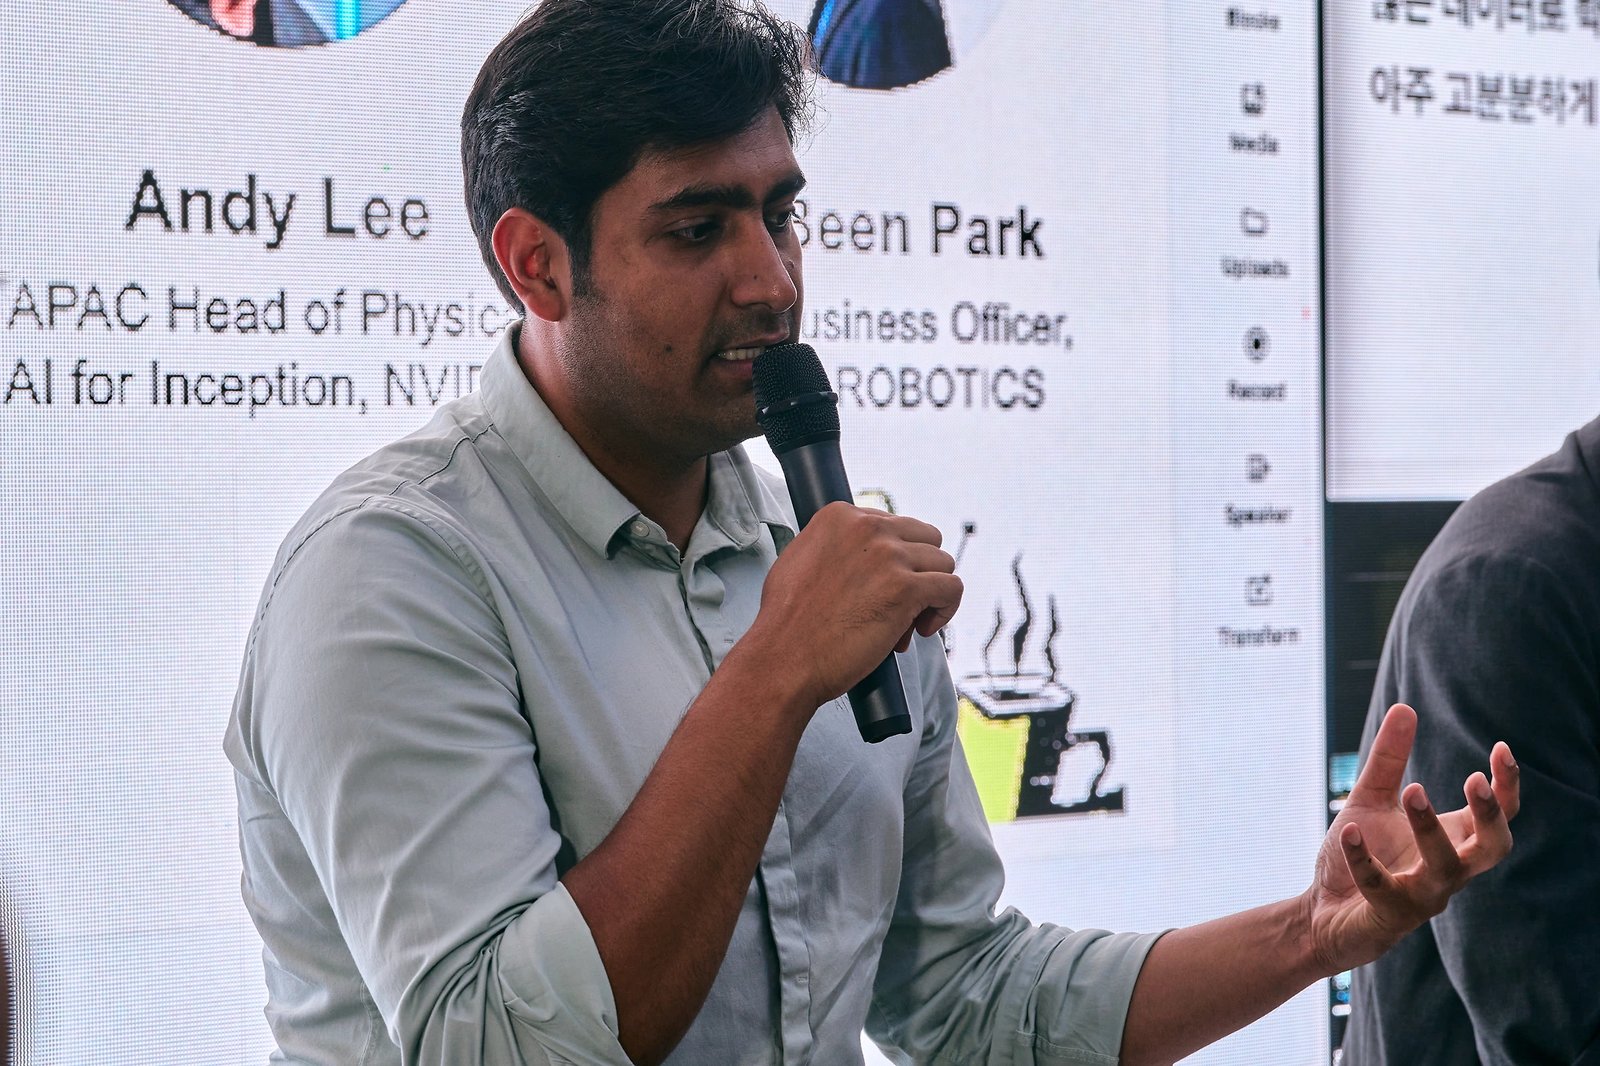
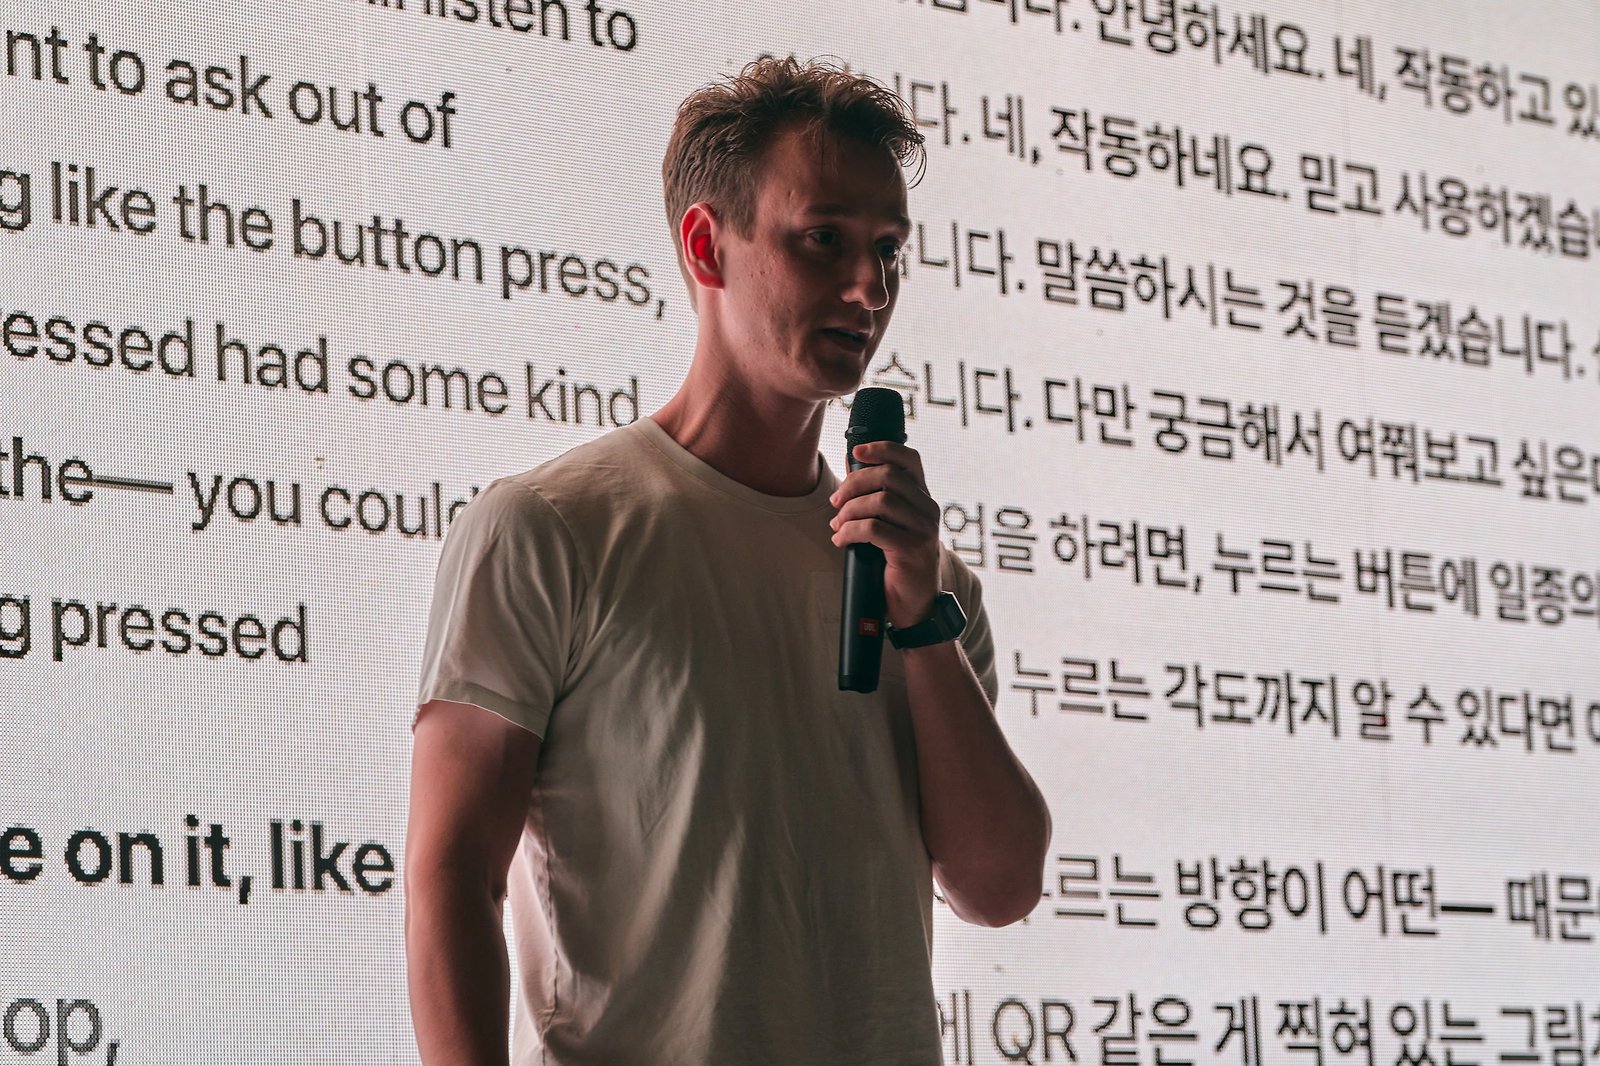
두 번째 세션은 Nebius에서 피지컬 AI 생태계를 맡은 Dhruv Diddi 님이었습니다. 서울이 제조의 중심이라 GPU와 로봇과 이 기술을 서울에 가져오고 싶었다며 말문을 열었고, 이 발표가 끝날 때쯤 모두가 로보틱스와 피지컬 AI 용어가 편해지고 그걸로 제대로 대화할 수 있을 만큼은 되는 것이 목표라고 했습니다. 슬라이드는 디지털 AI와 피지컬 AI를 나란히 놓았습니다. 디지털 AI의 출력은 화면 속 토큰이라 환각은 그냥 틀린 텍스트이고 오류 비용은 0입니다. 피지컬 AI의 출력은 현실에 바로 연결된 모터 토크라서 환각은 물리적 충돌이 되고 오류 비용은 치명적입니다. 유리잔을 떨어뜨리지 말라는 명령 하나가 결국 관절 각도와 토크로 바뀌어야 한다는 것입니다.
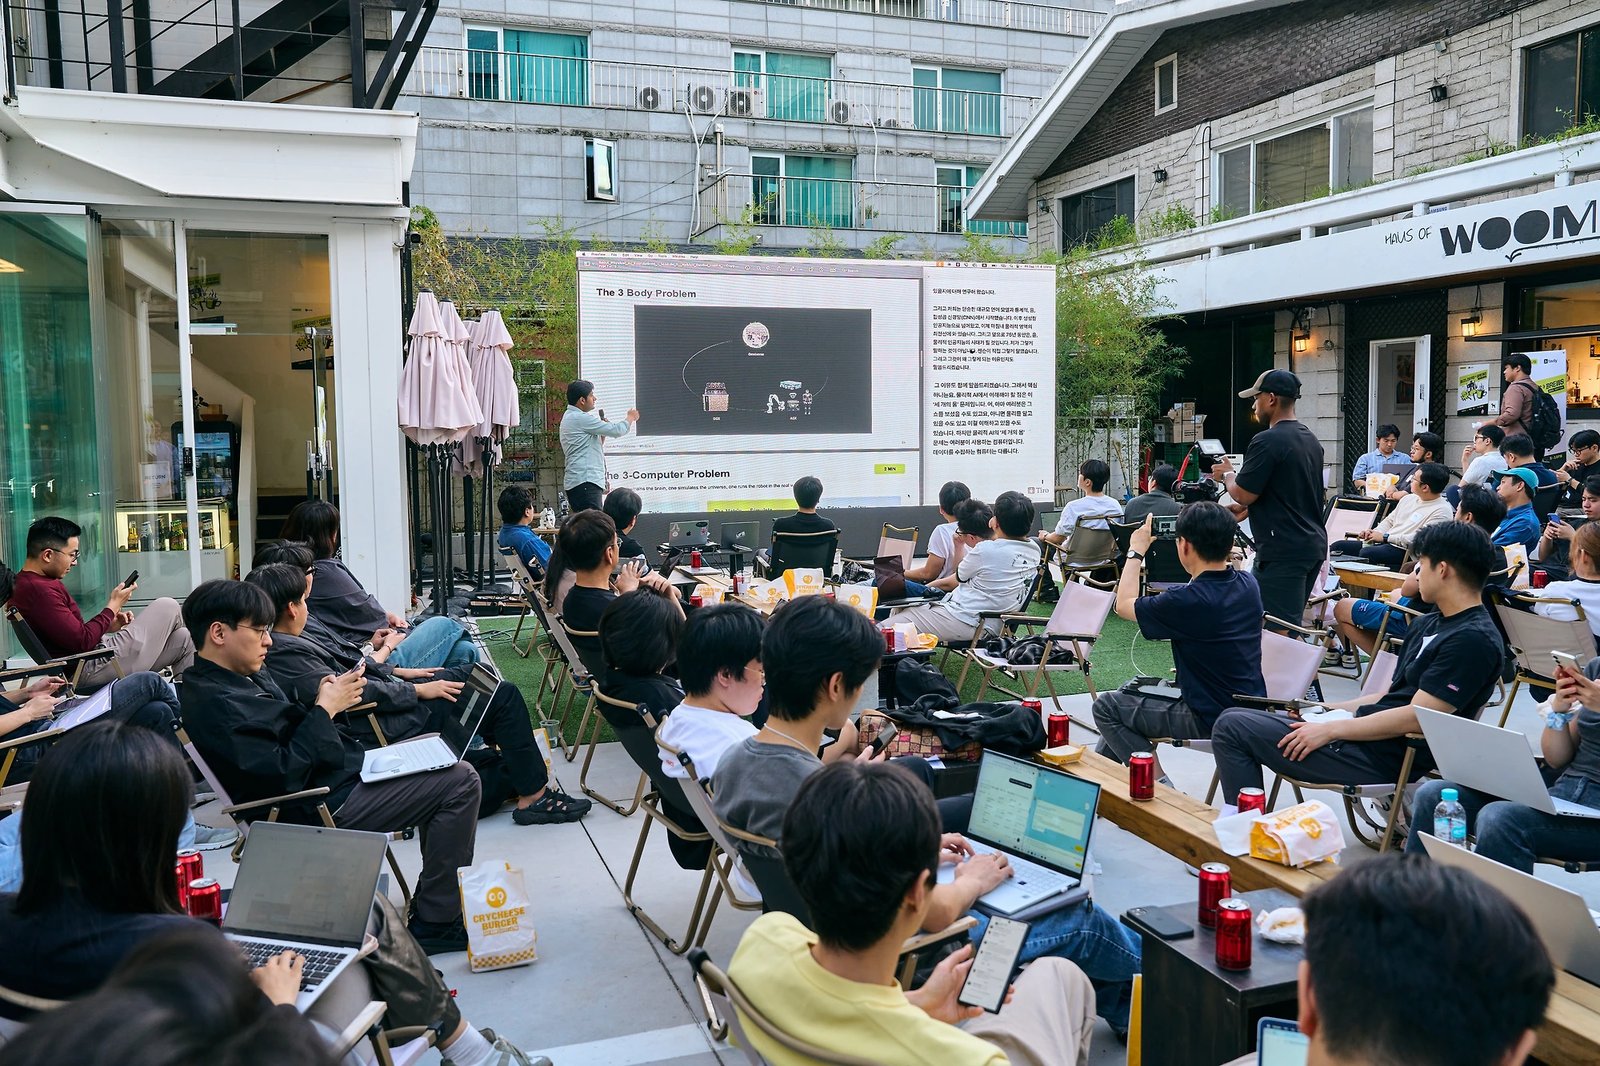
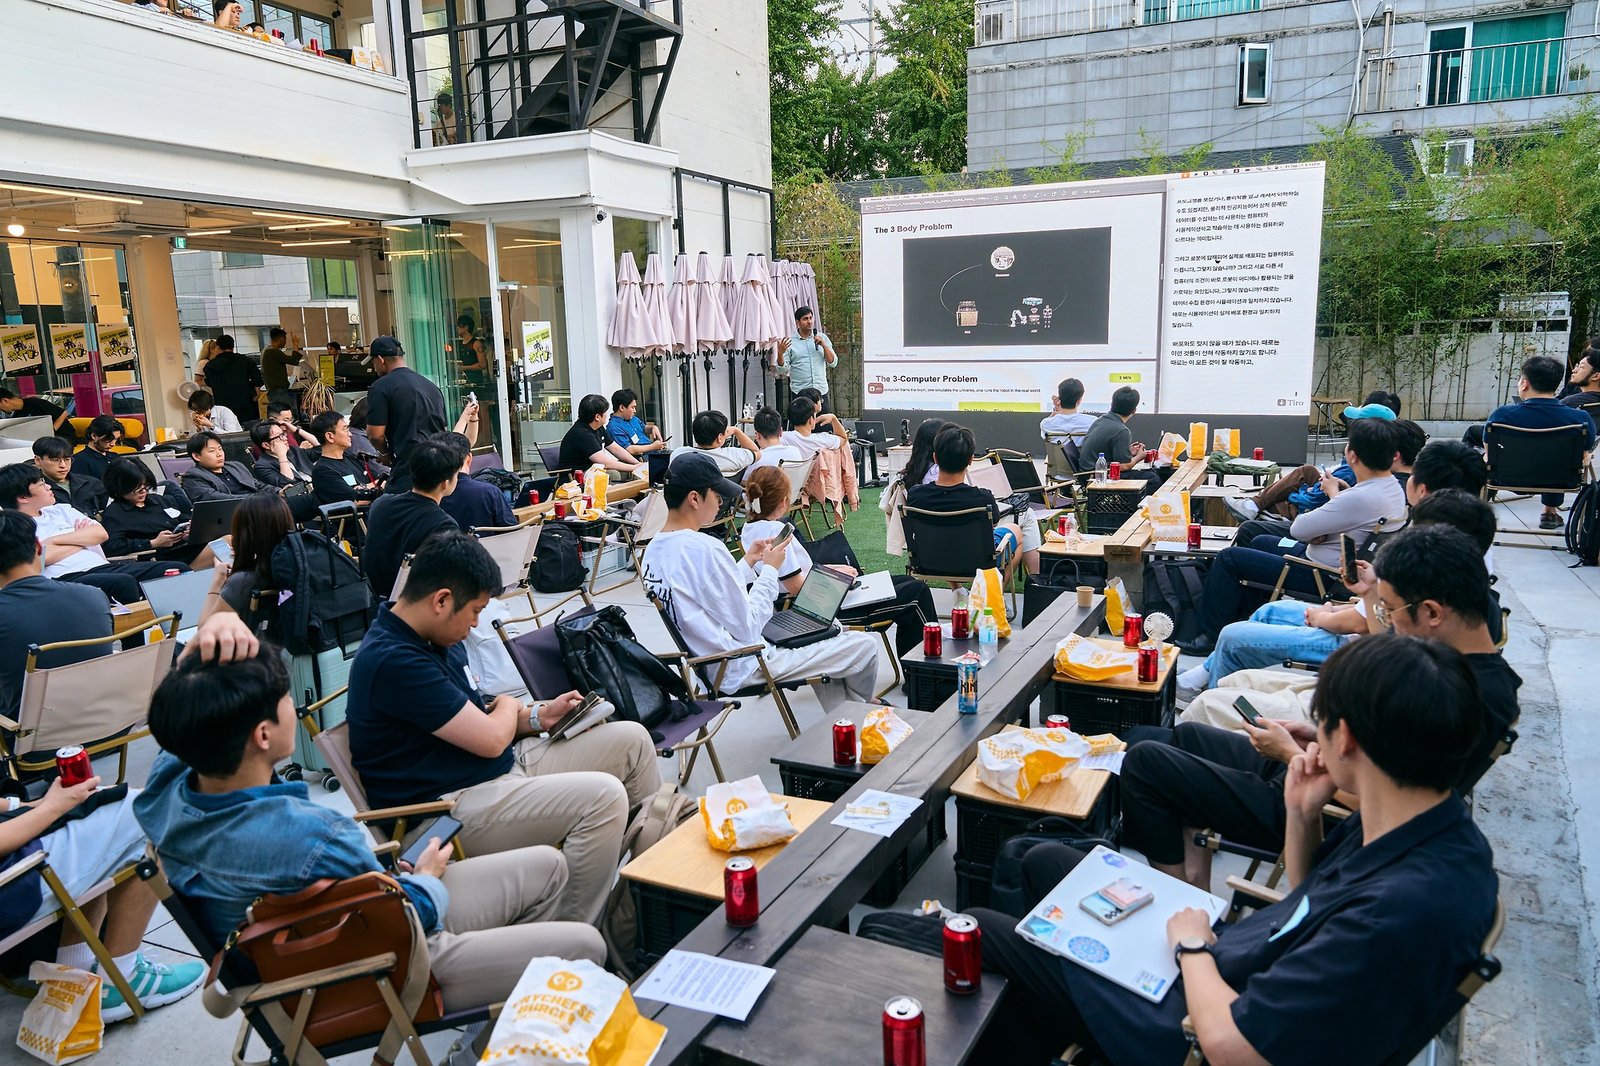
꼭 알아야 한다고 짚은 것은 삼체 문제였습니다. 데이터를 모으고 학습하는 공장, 시뮬레이션을 돌리는 매트릭스, 모델이 실제로 올라가는 엣지가 모두 다른 컴퓨터라는 뜻입니다. 공장은 DGX급 GPU 클러스터이고, 매트릭스는 디지털 트윈과 합성 데이터를 만드는 RTX급 서버이며, 엣지는 밀리초 단위로 반응해야 하는 온보드 컴퓨터입니다. 이 세 컴퓨터의 조건이 서로 맞지 않는 것이 로봇이 아직 어디에나 있지 못한 이유라고 했습니다. 데이터 수집이 시뮬레이션과 안 맞을 때가 있고 시뮬레이션이 배포와 안 맞을 때도 있는데, 온라인에서 보는 멋진 영상은 전부 잘 맞은 경우라는 설명이 솔직했습니다.
모델 이름도 같은 틀로 풀었습니다. LLM은 텍스트를 넣으면 텍스트가 나오고, VLM은 이미지와 텍스트를 넣으면 예나 아니오로 답하고, VLA는 이미지와 텍스트를 넣으면 로봇의 행동이 나옵니다. VLA는 말로 답하지 않고 이 장면과 이 명령을 봤을 때 모터가 무엇을 해야 하는지로 답한다는 것입니다. 로봇이 배울 데이터는 세 군데서 옵니다. 가장 확장성이 좋은 것은 영상이지만 스마트폰 영상에는 힘이나 관절 정보가 없고, 시뮬레이션은 하룻밤에 수백만 에피소드를 만들지만 물리가 근사치라 현실과 어긋나며, 사람이 로봇을 직접 조종하는 원격조작은 행동과 상태가 완벽하게 짝지어지는 대신 한 시간에 5개에서 50개밖에 못 모읍니다.
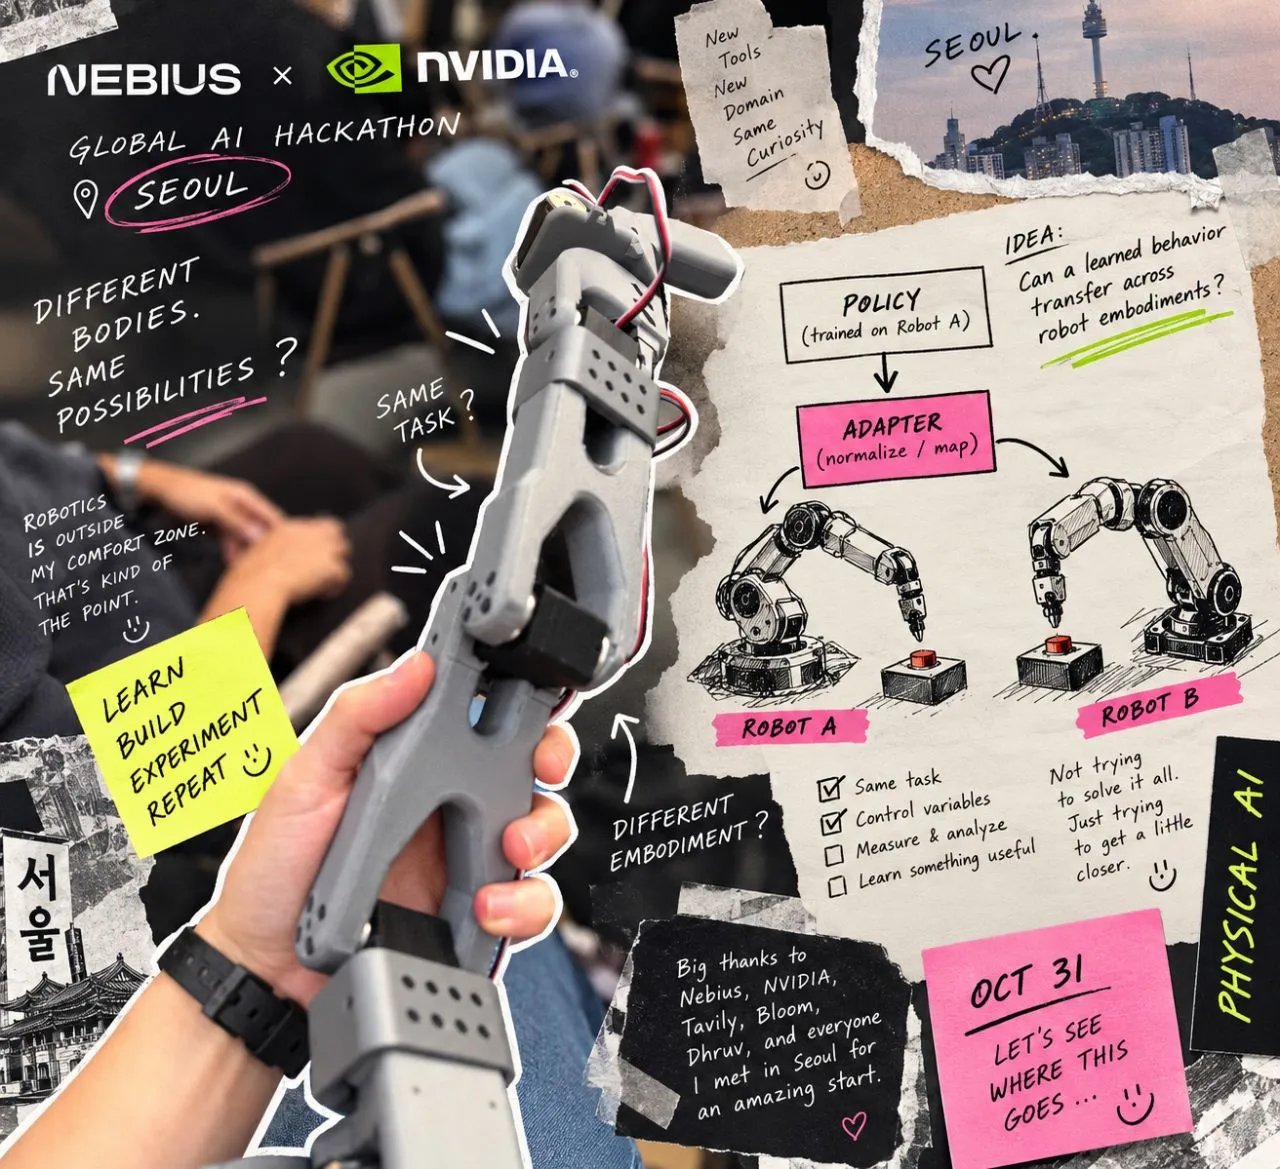
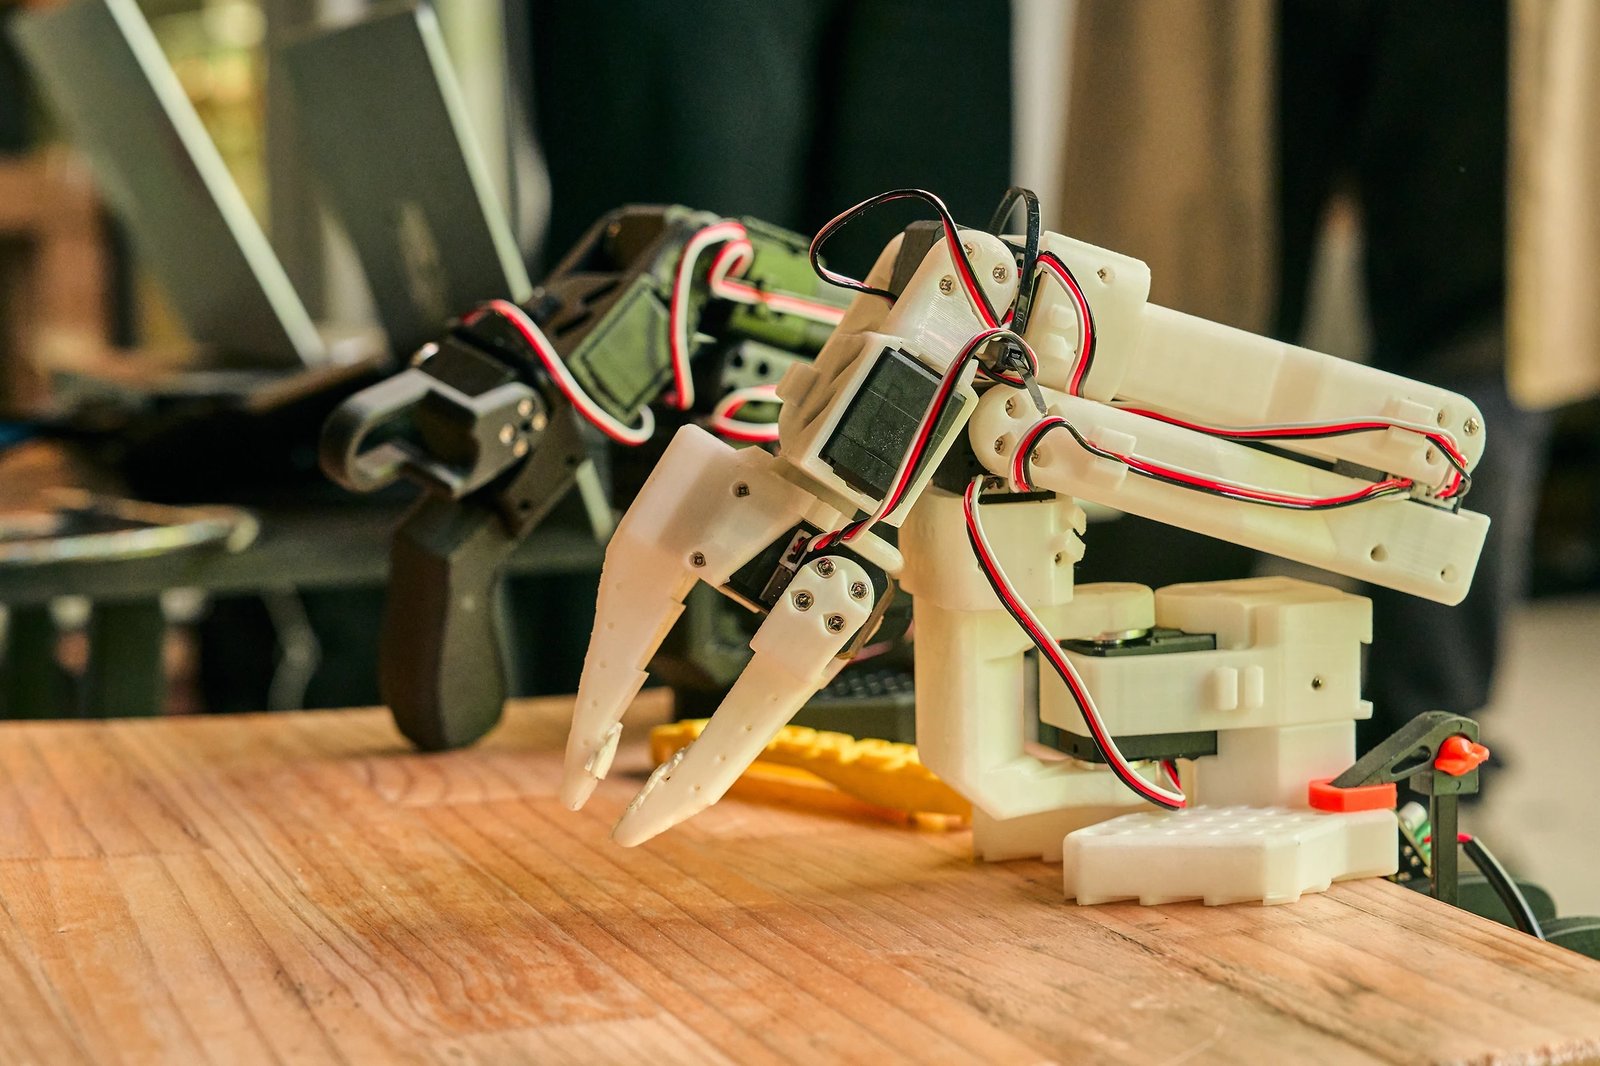
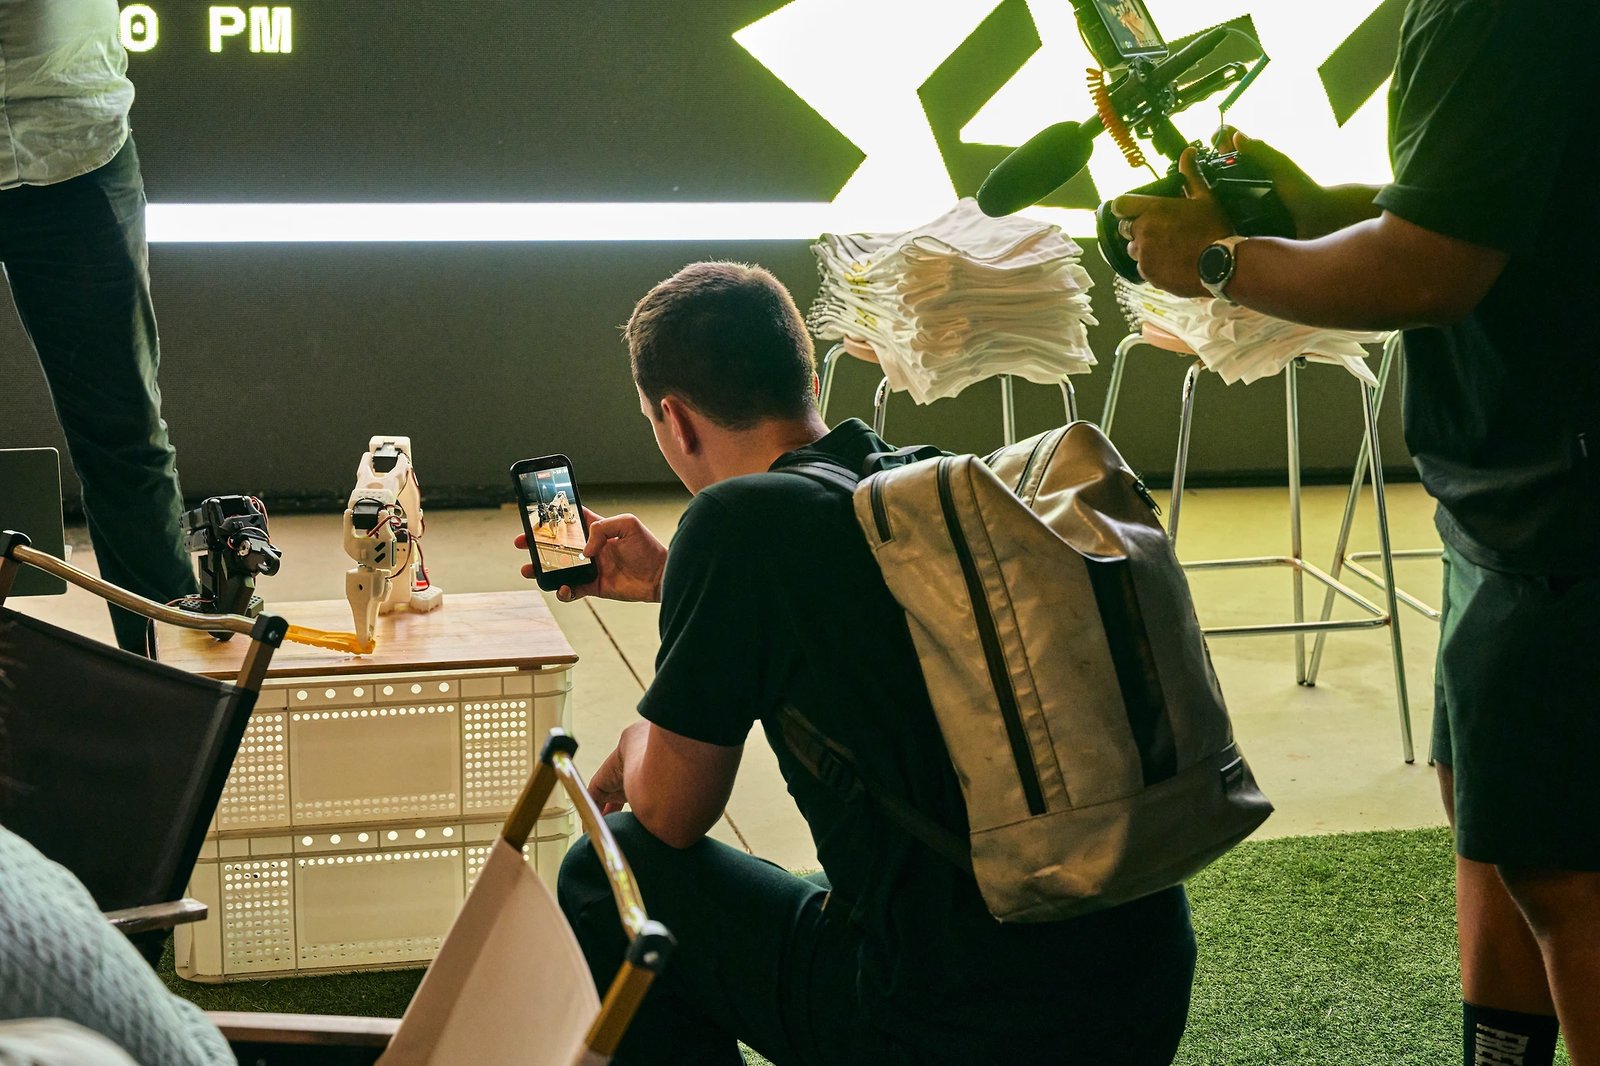
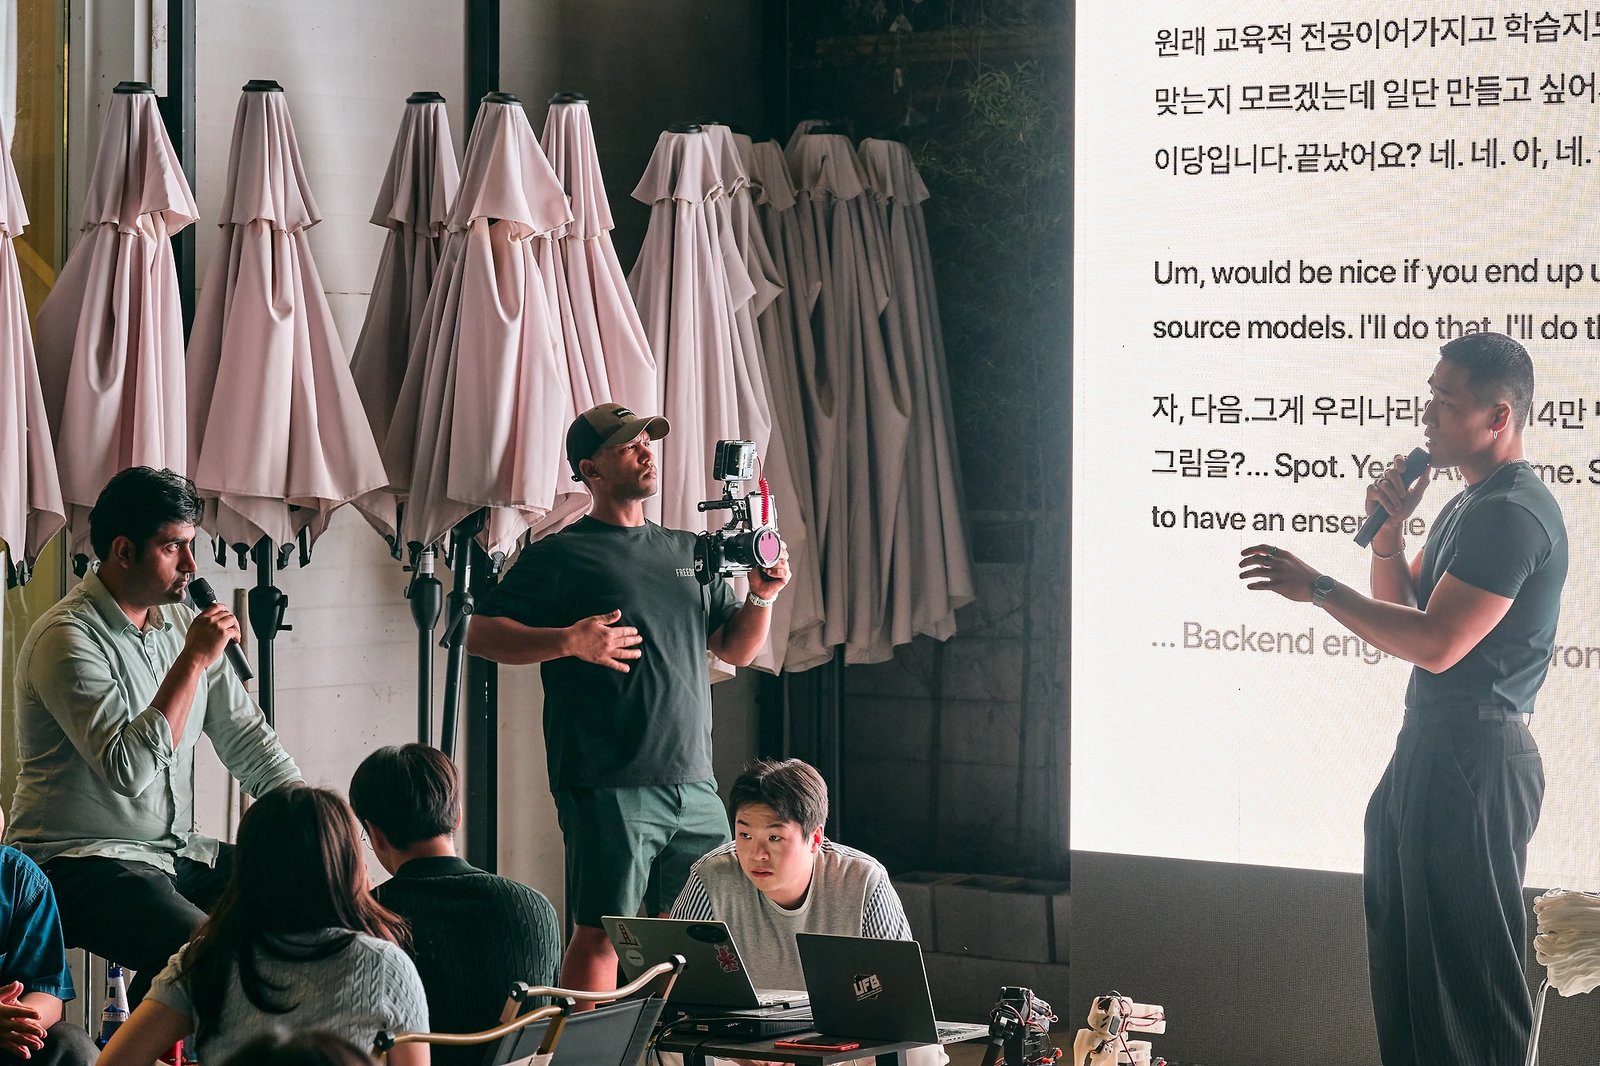
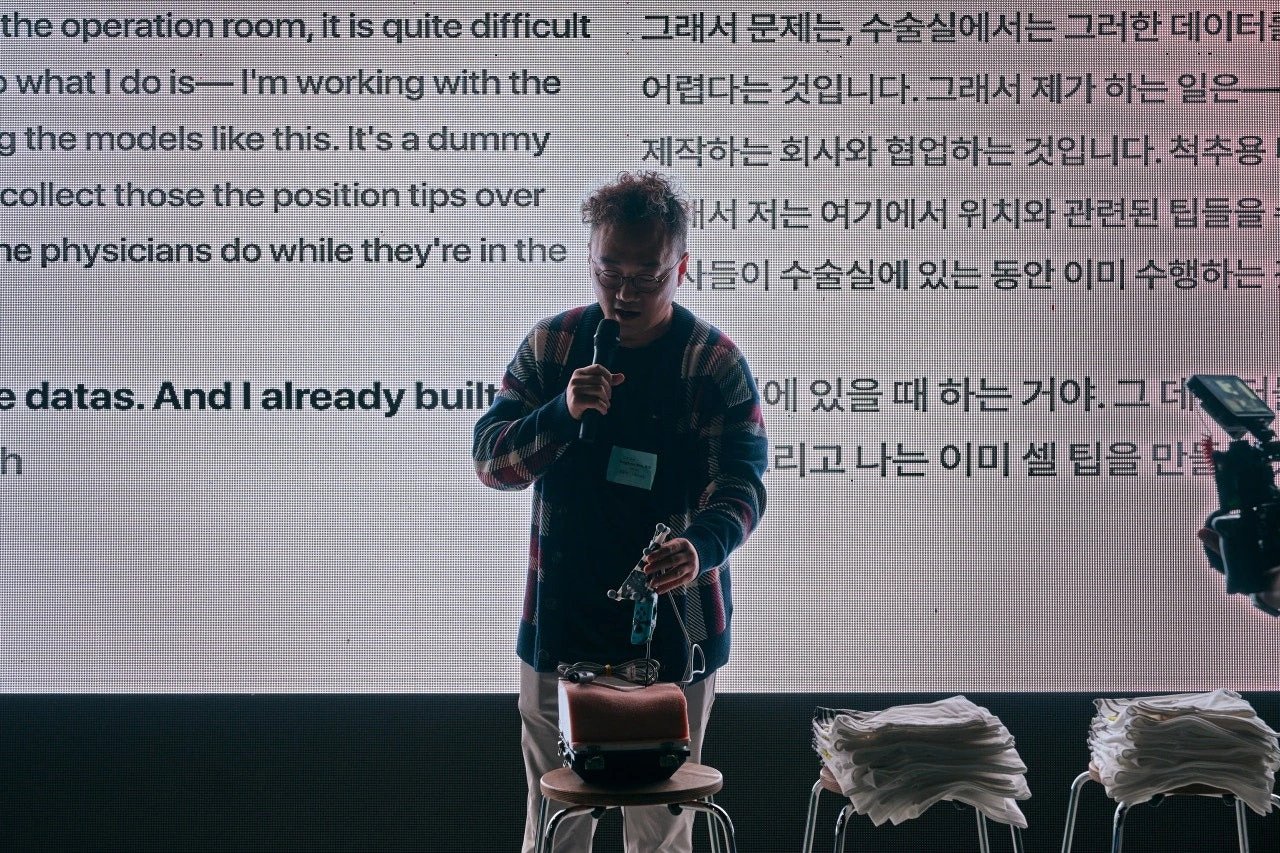
이 대목에서 원격조작용 오픈소스 로봇 팔을 꺼내 객석에 돌렸습니다. 인터넷에서 200달러 정도면 살 수 있고 3D 프린팅이라 직접 고칠 수도 부술 수도 있으며 모터도 직접 구할 수 있어서, 지금 구할 수 있는 로봇 중 가장 확장성이 좋다고 했습니다. 리더 팔을 움직이면 팔로워 팔이 그대로 따라 하는 방식으로 에피소드를 수천 개 모아 그 궤적으로 학습시킵니다. 모방학습과 강화학습은 로봇이 물체와 상호작용하느냐로 가르면 쉽다고 했습니다. 온라인에서 보는 춤추고 운동하는 로봇 영상은 물체와 상호작용하지 않으니 전부 강화학습이고, 물컵을 다루게 하려면 모방학습을 씁니다. 원칙은 먼저 따라 하고 보상은 나중이었습니다. 사람의 시연을 복제하는 모방학습은 빠르고 샘플 효율이 좋아 며칠 만에 성공률 80퍼센트의 출발점을 만들지만 사람보다 잘할 수는 없고, 그다음 강화학습이 모방학습으로는 닿지 않는 드문 실패들을 갈아냅니다. 텍스처와 마찰과 조명을 무작위로 바꿔가며 학습시켜야 현실의 변화에도 버팁니다.
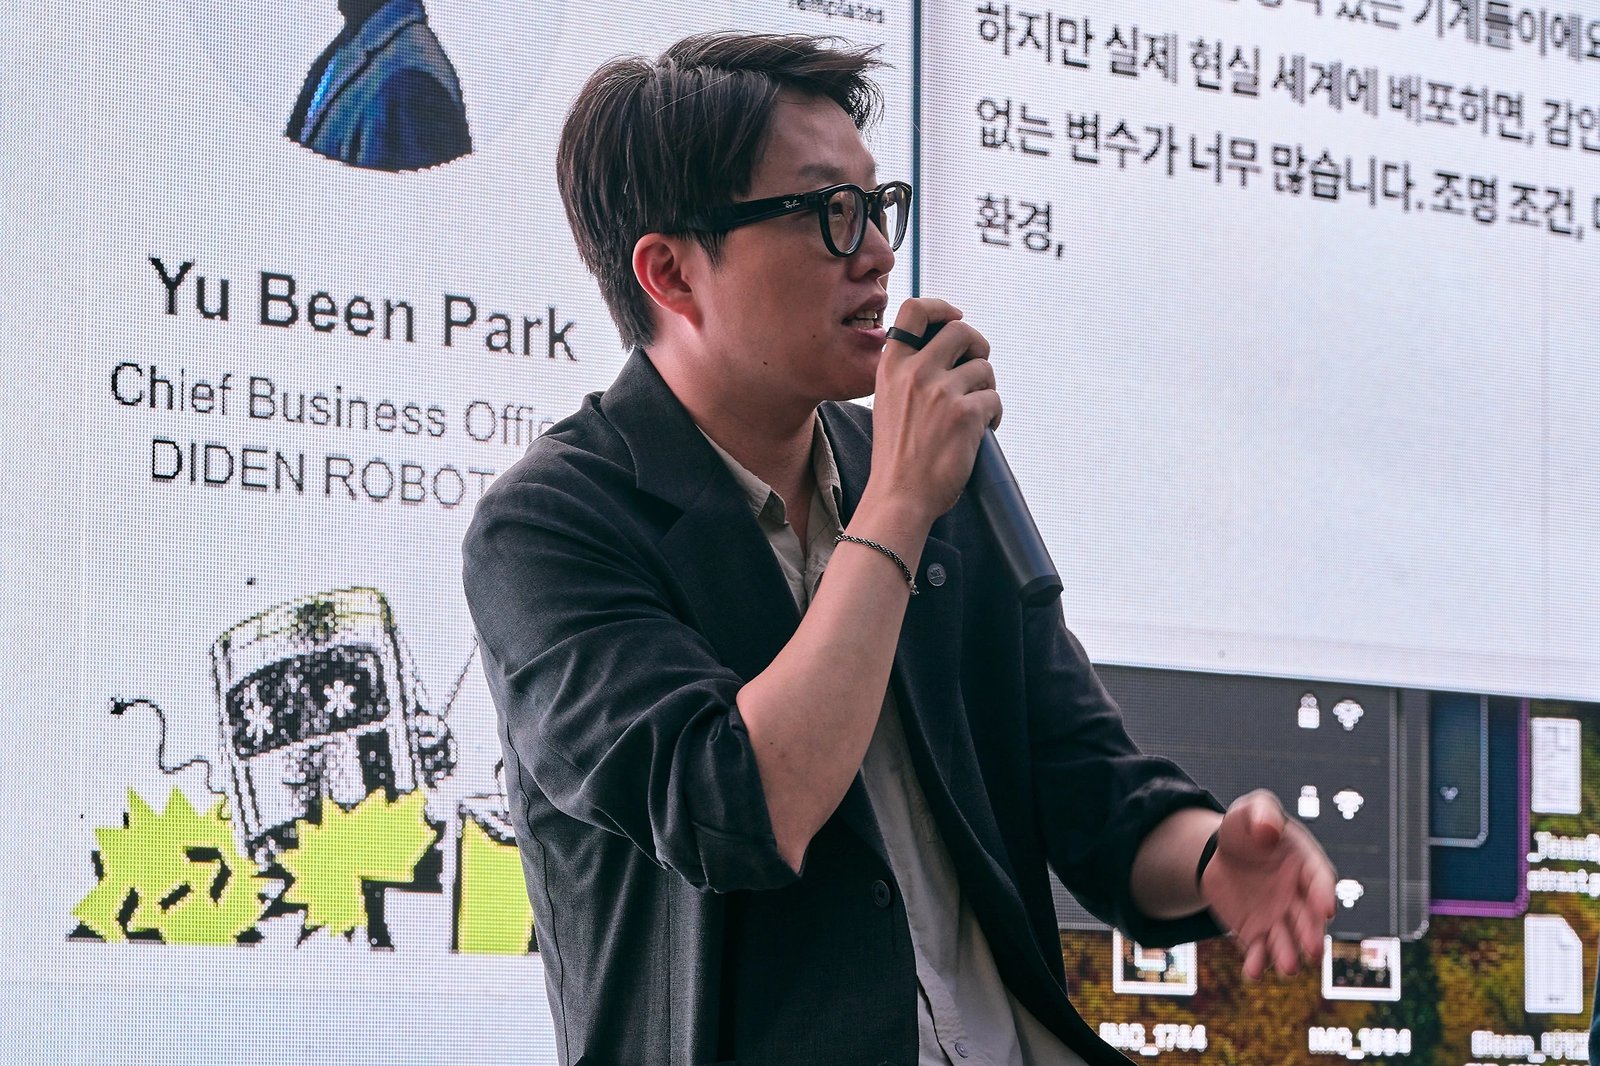
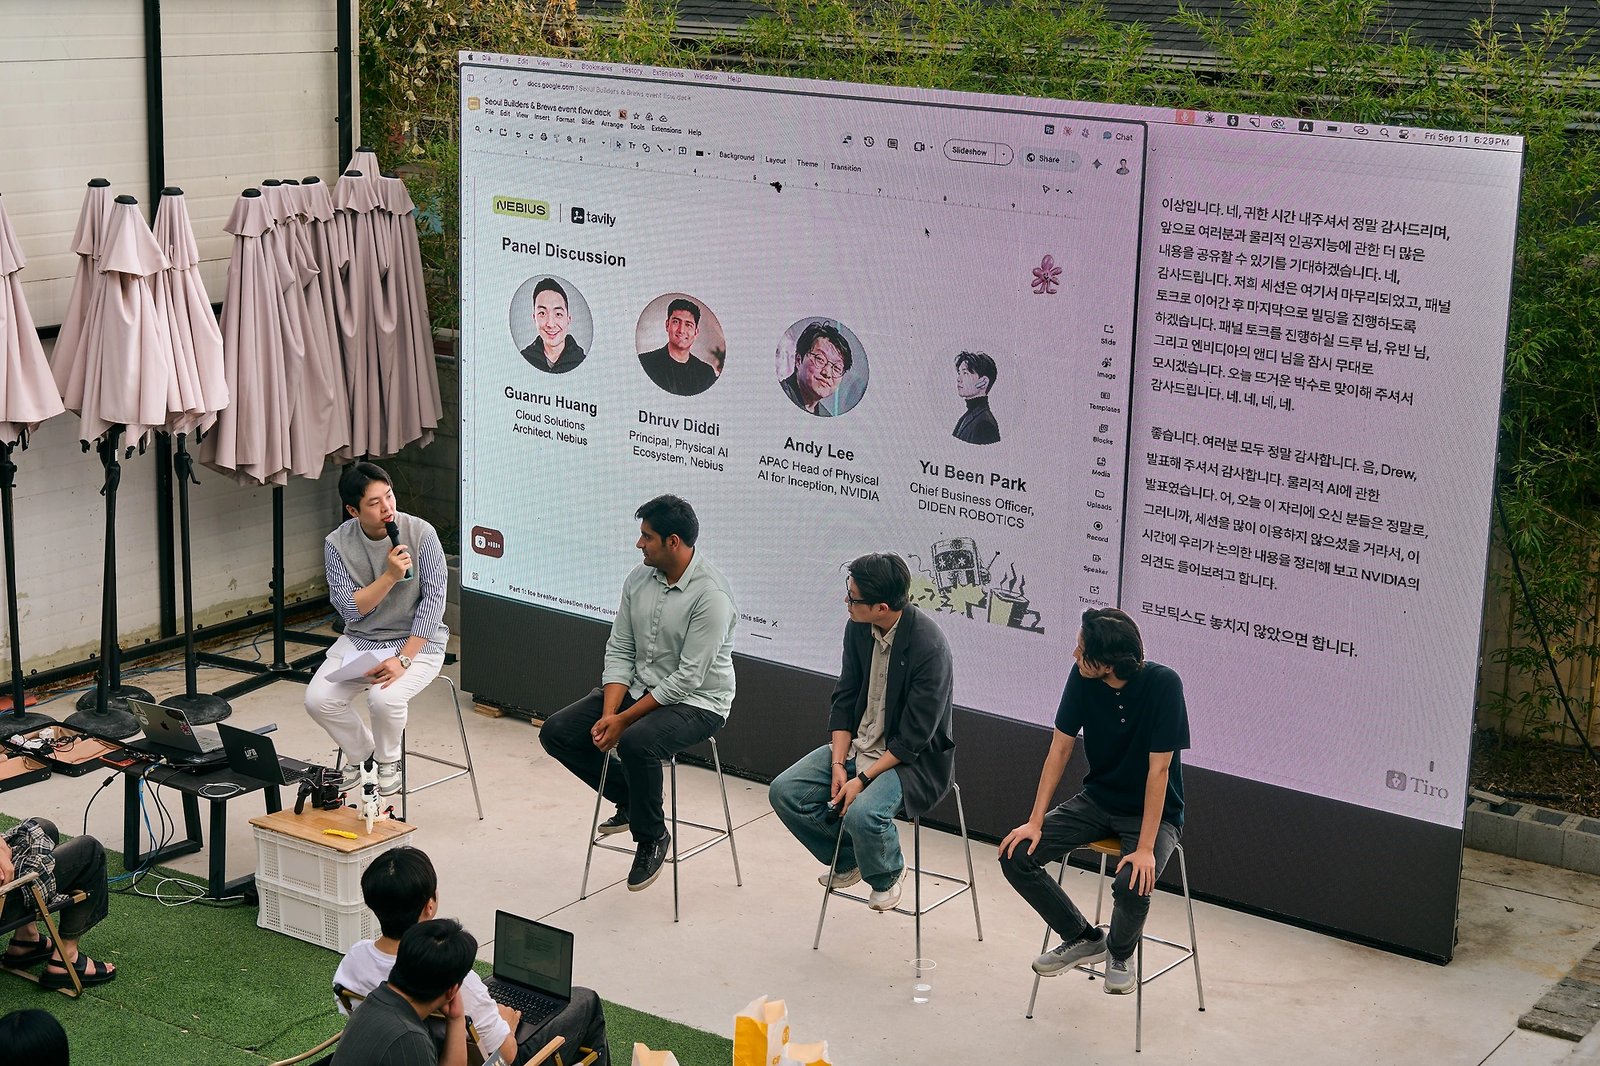
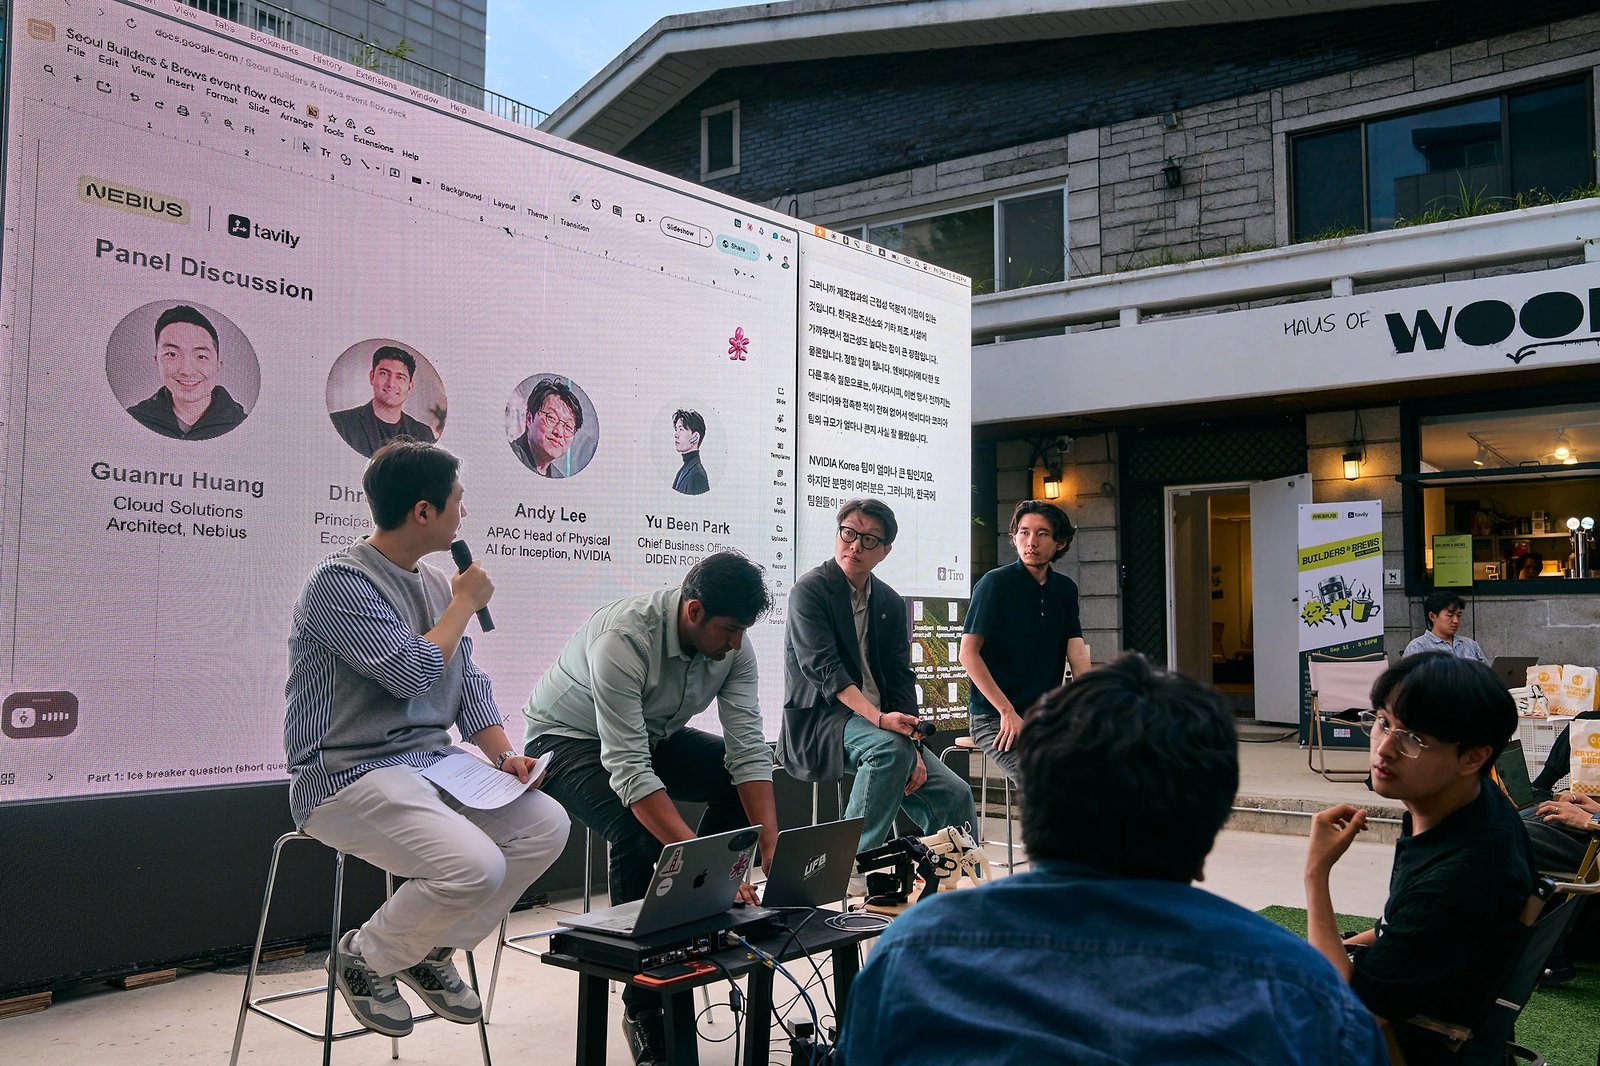
패널에는 NVIDIA에서 아시아태평양 피지컬 AI와 스타트업 프로그램을 맡은 Andy Lee 님, 앞서 발표한 Dhruv Diddi 님, 그리고 Bloom 멤버이기도 한 디든로보틱스 CBO 박유빈 님이 함께했습니다. 디든로보틱스는 자석 발로 철제 구조물의 벽과 천장을 타고 다니며 용접과 검사를 하는 사족보행 로봇을 만듭니다. 삼성중공업 실증을 통과해 납품에 들어갔고 HD한국조선해양과는 조선 블록 내부 용접 로봇을 함께 개발하는 중입니다. Andy Lee 님은 Cosmos를 세상을 이해하려는 월드 파운데이션 모델로, GR00T를 세상에서 배운 것을 실제 행동으로 바꾸는 로봇 파운데이션 모델로 설명했습니다.
로봇에게 가르칠 때 가장 어려운 것을 묻자 Dhruv Diddi 님은 물리 세계를 상대하는 일이라고 답했습니다. 시뮬레이션 학습은 많이 발전했지만, 앞 세대 피지컬 AI 스타트업이 겪었듯 시뮬레이션에서 100점을 받았으니 충분하다고 여겼다가 현실에 배포하고 나서야 문제를 자율성 단계로 다시 쪼개야 한다는 것을 깨닫게 됩니다. 가장 어려운 단계로 배포를 꼽았고, 배포가 매끄러워지려면 배포 자체가 더 많아져야 한다고 했습니다. 박유빈 님에게 시뮬레이션을 충분히 돌린 뒤 현실에 넣으면 무엇이 먼저 깨지는지 묻자 구체적인 답이 돌아왔습니다. 강화학습 시뮬레이터를 처음 만들 때는 평평한 바닥과 반듯한 각도 같은 이상적인 환경을 만드는데, 실제 조선소에서는 용접을 하면 바닥에 작은 쇳조각이 흩어지고 로봇이 그걸 밟으면 미끄러져 제어를 잃을 수 있다는 것입니다. 이건 아주 단순한 예일 뿐이고 잘못될 수 있는 변수는 셀 수 없이 많아서, 시스템을 빠르게 반복하려면 먼저 실제 환경과 실제 로봇을 갖추고 거기서 계속 돌려봐야 한다고 했습니다. 현실 없이는 어떤 해법도 만들 수 없다는 말이었습니다.
피지컬 AI에서 더 어려운 것이 AI인지 기계인지 묻자 Andy Lee 님은 확실히 반반이라고 했습니다. AI 모델은 기하급수적으로 좋아지고 있지만 현실에 배포하는 순간 계산에 넣을 수 없는 변수가 쏟아집니다. 조명 조건이 다르고 환경이 다르고 조명 몇 개가 안 들어와 있을 수도 있어서, 하드웨어가 AI를 따라가야 하고 지금 딱 그 단계에 있다는 것입니다. 컴퓨트를 더 쓰면 팀이 더 나아지느냐는 질문에 Dhruv Diddi 님은 반대쪽을 짚었습니다. 물리 세계는 전문화를 강요해서, 너무 넓게 퍼진 데이터로 학습시키면 가중치가 제대로 자리 잡지 못하니 지금은 조명 한 종류와 로봇 한 종류와 환경 하나로 좁혀야 잘 된다는 것입니다. 실제로 피지컬 AI 모델은 20억에서 70억 파라미터 정도로 작은 편인데, 멀티모달이라 더 촘촘하게 학습시킬 수 있기 때문입니다. 결국 피지컬 AI는 더 효율적으로 생각하게 만들고, 인터넷에서 모은 데이터를 큰 모델에 잔뜩 넣어 되게 만드는 패러다임이 아니라고 했습니다.
한국의 강점을 묻자 Dhruv Diddi 님은 제조 현장과 가깝고 그런 공간에 드나들 수 있다는 데서 오는 강점이 분명히 크다고 했습니다. 제조 환경을 직접 통제할 수 있어서 데이터 수집에서 앞서가고 다른 나라보다 모델을 더 일찍 배포할 수 있을 거라는 이야기였습니다. Andy Lee 님은 한국이 NVIDIA에게 전략적인 곳이라고 했습니다. 국제로봇연맹 집계로 한국은 제조업 노동자 1만 명당 산업용 로봇이 1,220대로 세계 1위이고 세계 평균 132대의 아홉 배가 넘습니다. 동시에 인구가 줄고 현장에서 일할 사람을 구하기가 어려워지면서 제조 현장의 수요도 뚜렷해졌습니다. 설립 10년 이내 법인이면 누구나 무료로 들어갈 수 있는 NVIDIA Inception을 들어본 적 있느냐며 손을 들어보라고 했을 때 올라온 손은 많지 않았습니다.
창업을 돌아보면 무엇을 더 잘하겠느냐는 질문에 박유빈 님의 답에는 망설임이 없었습니다. 피지컬 AI에서는 하드웨어를 해야 한다는 것이었습니다. 외부 하드웨어를 쓰면 제품으로서 시스템을 최적화하는 데 분명한 한계가 있고, 소프트웨어 계층만 최적화하고 있으면 고객 입장에서 그 소프트웨어를 빼고 다른 업체 것으로 바꾸기가 너무 쉽기 때문입니다. 소프트웨어를 정말 잘하는 개발자라면 하드웨어 공동창업자를 찾으라고 했고, 언어 모델이 좋아질수록 소프트웨어는 점점 더 쉽게 대체된다고 덧붙였습니다. 고객에게 계속 붙어 있으려면 하드웨어와 소프트웨어를 다 하고 수직 통합해서 패키지로 팔라는 결론이었습니다.
오늘 빌딩을 시작하는 사람에게 하나만 조언한다면 무엇이냐는 마지막 질문에 Dhruv Diddi 님은 작게 시작하라고 했습니다. 오늘 밤 만드는 것이 최고의 제품이 아닐 수도 있고 기대한 결과가 안 나올 수도 있으니, 하루 만에 최고의 모델을 노리지 말고 작은 목표를 작은 걸음으로 세운 다음 그 목표를 실제로 이뤘는지 재보고 거기서부터 나아가라는 것이었습니다. 마이크는 마지막으로 박유빈 님에게 돌아갔는데, 요즘은 소프트웨어를 만들기가 꽤 쉬우니 하드웨어로 차별화해보는 건 어떻겠느냐는 답이었습니다.
패널이 끝나고 해커톤이 시작됐습니다. 크레딧은 클라우드와 Token Factory 두 가지로 각각 100달러어치였고, 컴퓨트 크레딧은 신청자에게만 줬습니다. 사람들이 컴퓨트를 책임감 있게 써주길 바라서라고 했습니다. 팀을 꾸리고 무엇을 만들지 정한 팀이 8시에 나와 소개하는 순서도 있었습니다. 그사이 Dhruv Diddi 님은 질문하러 온 분들에게 데이터 이야기를 이어갔습니다. 사람 손에 그리퍼 모양의 장치를 쥐여주고 작업하게 하면 원격조작보다 싸게 데이터를 모을 수 있고, 로봇에서 로봇으로 직접 모으면 값어치가 더 올라가며, 가장 값진 것은 모델을 배포하면서 모은 데이터라는 이야기였습니다.
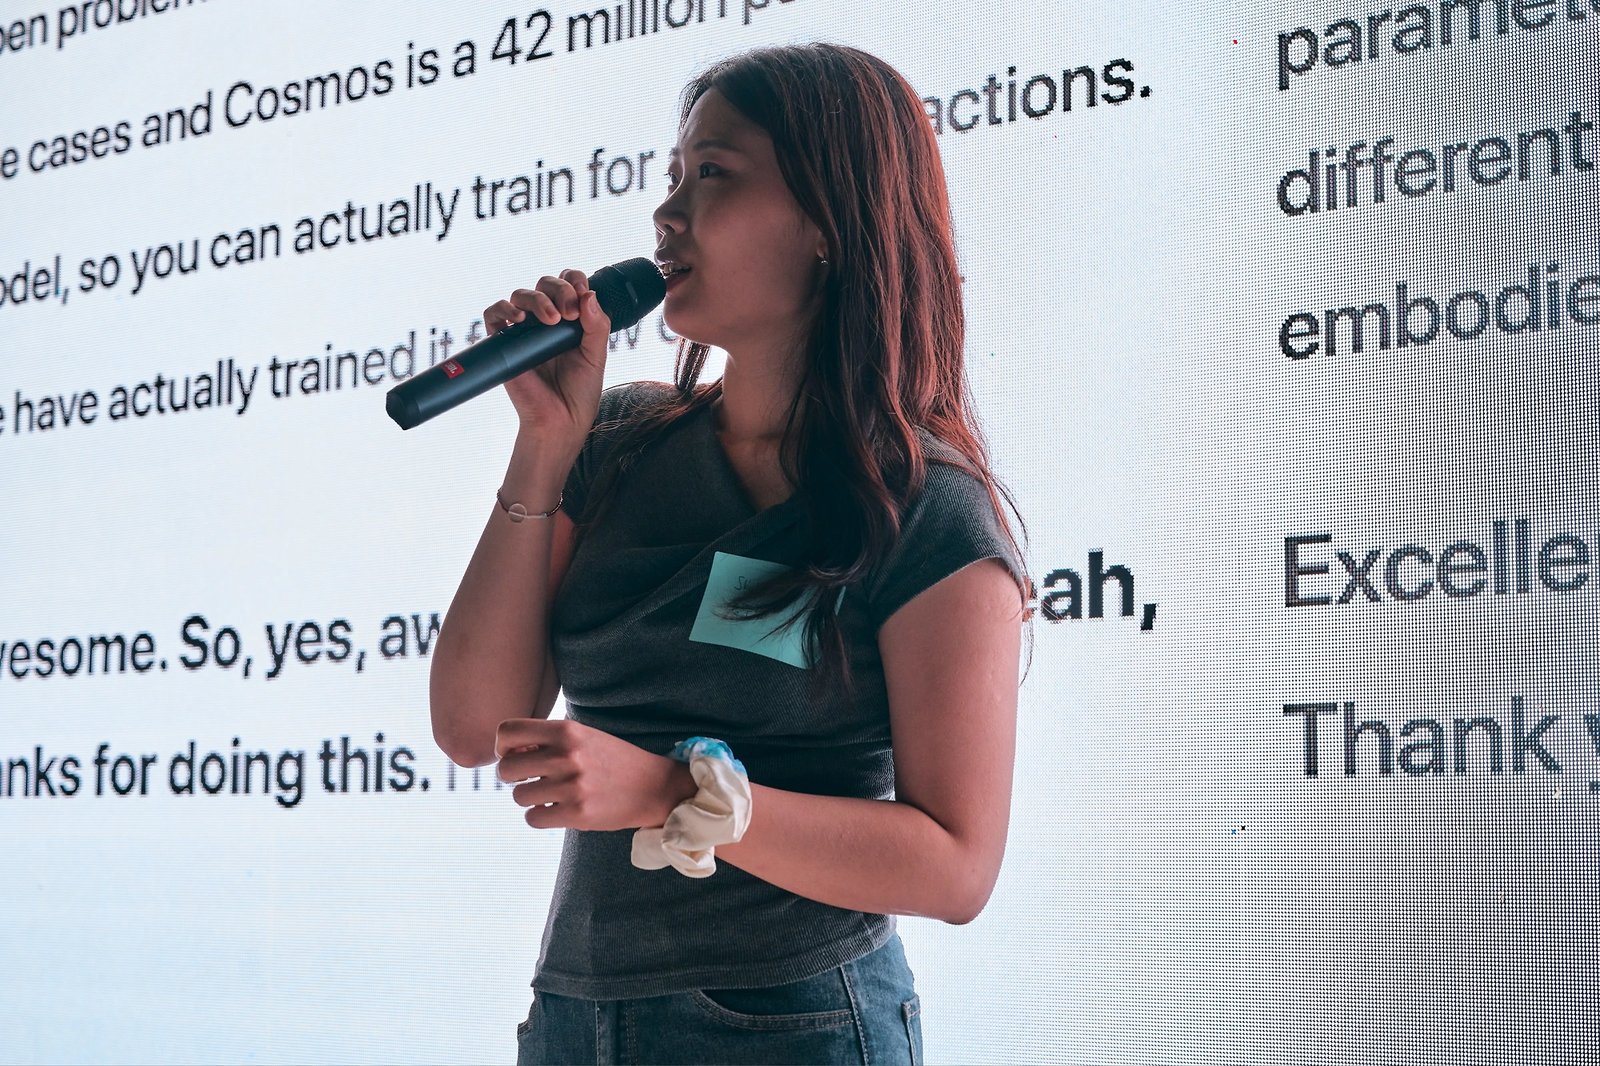
현장 사진
다음 이벤트